Update zurückdrehen: Welche Docker-Dienste vertragen den Weg zurück?
Ernstfall Teil 3: Nach dem Zurückdrehen per Tag starteten Nextcloud, Forgejo, MariaDB und Redis nicht mehr, Paperless-ngx, Vaultwarden, Uptime Kuma und ntfy liefen weiter. Die Kopie von vor dem Update rettete alle acht.
Mit KI erstellt – redaktionelle Prüfung ausstehend
Werbung Mit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Ein Update ist eingespielt, und danach hakt etwas: ein Fehler in der neuen Version, ein Plugin, das nicht mehr will. Der naheliegende Reflex ist, in der compose.yaml die alte Version einzutragen und neu zu starten. Ob das gut geht, hängt vom Dienst ab. Für diese Anleitung wurden acht verbreitete Dienste aktualisiert, mit Daten gefüllt und dann auf die alte Version zurückgedreht, jeder dreimal.
Dies ist Teil 3 der Reihe „Ernstfall“. Jeder Teil macht absichtlich etwas kaputt, misst, was passiert, und zeigt den Weg zurück.
Was Sie brauchen
- Einen Linux-Server mit Docker und Docker Compose, siehe Docker und Docker Compose auf Linux installieren.
- Dienste mit Bind-Mounts für die Daten. Die Beispiele nutzen den Ordner
./dneben dercompose.yaml. - Feste Versionen in der
compose.yaml, damit Sie wissen, wohin Sie zurückwollen. - Freien Platz in der Größe des Datenordners für die Kopie.
Schritt 1: Vor dem Update den Datenordner kopieren
Stoppen Sie den Dienst und kopieren Sie den Datenordner, bevor Sie die Version ändern. Eine Kopie im laufenden Betrieb taugt bei Datenbanken nicht, das zeigt Teil 1 der Reihe:
$ docker compose stop
$ sudo cp -a d d-vor-update
Notieren Sie sich die bisherigen Versionen aus der compose.yaml. Danach tragen Sie die neuen ein und starten:
$ docker compose up -dVerifizieren: sudo du -sh d d-vor-update zeigt zwei Ordner ähnlicher Größe, und der Dienst läuft mit der neuen Version.
Schritt 2: Prüfen, ob der Dienst den Weg zurück verträgt
Bei Paperless-ngx, Vaultwarden, Uptime Kuma und ntfy startete der Dienst im Test nach dem Zurückdrehen der Version und zeigte alle Testdaten. Tragen Sie die alte Version ein und legen Sie den Container neu an:
$ docker compose up -d --force-recreateNextcloud, Forgejo, MariaDB und Redis brachen bei den getesteten Versionssprüngen mit eindeutigen Meldungen ab, die in Ergebnis 2 stehen. Dann bleibt nur Schritt 3.
Verifizieren: docker compose ps zeigt den Dienst als Up, und die Daten aus der Zeit nach dem Update sind da.
Schritt 3: Die Kopie zurückspielen
Startet der Dienst mit der alten Version nicht, ersetzen Sie den Datenordner durch die Kopie aus Schritt 1 und starten mit der alten Version:
$ docker compose stop
$ sudo rm -rf d
$ sudo cp -a d-vor-update d
$ docker compose up -d --force-recreate
Bedenken Sie, was dabei verloren geht: alles, was zwischen Update und Rückweg geschrieben wurde. Im Test fehlten genau diese Einträge, alles von vor dem Update war da.
Verifizieren: Der Dienst startet mit der alten Version und zeigt den Stand von vor dem Update.
So wurde gemessen
Alle acht Dienste liefen unter Docker 29.8.2 und Docker Compose 5.5.1 mit Bind-Mounts. Die Dienste mit eigener Datenbank nutzten SQLite, Paperless-ngx zusätzlich einen eigenen Redis-Container, der nicht zurückgedreht wurde. MariaDB lief mit MARIADB_AUTO_UPGRADE=1, Redis speicherte seine Daten mit SAVE auf die Platte. Die Versionen:
| Dienst | alt | neu |
|---|---|---|
| Nextcloud | 34.0.6 | 35.0.3 |
| Forgejo | 16.0.7 | 17.0.1 |
| Paperless-ngx | 3.3.4 | 3.4.2 |
| Vaultwarden | 1.36.0 | 1.37.5 |
| Uptime Kuma | 1.23.17 | 2.5.11 |
| MariaDB | 11.4.13 | 11.8.9 |
| Redis | 7.4.12 | 8.10.3 |
| ntfy | 2.36.0 | 2.38.0 |
Jeder Durchgang begann mit frischen Daten in der alten Version. Jeder Dienst bekam einen Eintrag A: eine Datei in Nextcloud, ein Repository in Forgejo, ein Tag in Paperless-ngx, eine Einladung in Vaultwarden, einen Monitor in Uptime Kuma, eine Zeile in MariaDB, einen Schlüssel in Redis, eine Nachricht in ntfy. Dann wurden alle gestoppt, der Datenordner kopiert und die neue Version gestartet. Danach kam Eintrag B dazu. Dann wurde auf die alte Version zurückgedreht und geprüft, ob der Dienst startet und welche Einträge da sind. Zum Schluss wurde die Kopie zurückgespielt und die alte Version wieder gestartet. Das lief dreimal, mit demselben Ergebnis.
Ergebnis 1: Vier vertragen den Weg zurück, vier nicht
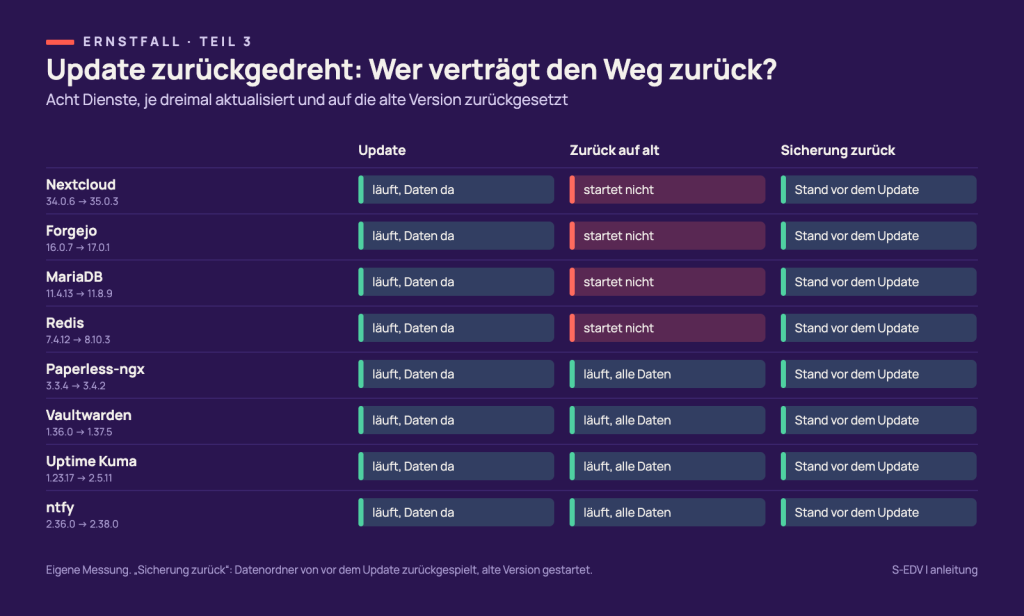
Das Update selbst lief bei allen acht Diensten ohne Eingriff, alle Daten von vorher waren danach da. Nextcloud brauchte für das eigene Upgrade beim ersten Start 27 bis 30 Sekunden, die anderen waren nach 3 bis 6 Sekunden bereit.
Beim Zurückdrehen teilte sich das Feld. Paperless-ngx, Vaultwarden, Uptime Kuma und ntfy starteten mit der alten Version und zeigten beide Einträge, A und B. Bemerkenswert ist Uptime Kuma: Der Schritt von 2.5.11 zurück auf 1.23.17 ging über eine große Versionsgrenze, trotzdem meldete sich Version 1.23.17 an und zeigte beide Monitore. Geprüft wurden hier allerdings nur Anmeldung und Zahl der Monitore.
Ergebnis 2: Wie die anderen vier abbrechen
Die vier anderen beendeten sich beim Start, in allen drei Durchgängen mit derselben Meldung. Nextcloud vergleicht die Versionsnummer der Daten:
Can't start Nextcloud because the version of the data (35.0.3.2) is higher than the docker image version (34.0.6.2) and downgrading is not supported. Are you sure you have pulled the newest image version?Forgejo erkennt die neueren Migrationen in seiner Datenbank und hört bewusst auf:
Your Forgejo database has 6 migration(s) (…) for a newer version of Forgejo, …
Forgejo will exit to keep your database safe and unchanged.
Redis kann die Datei der neueren Version nicht lesen:
Can't handle RDB format version 15
Fatal error loading the DB, check server logs. Exiting.
MariaDB hatte die InnoDB-Wiederherstellung schon hinter sich und brach dann an der Transaktionsdatei tc.log ab:
[Note] Recovering after a crash using tc.log
[ERROR] Recovery failed! You must enable all engines that were enabled at the moment of the crash
[ERROR] Crash recovery failed. Either correct the problem (…) or delete tc log and start server with --tc-heuristic-recover={commit|rollback}
[ERROR] Can't init tc log
[ERROR] Aborting
Nextcloud und Forgejo verweigern den Start bewusst, um die Daten zu schützen. Redis kann das neuere Dateiformat nicht lesen. MariaDB scheiterte an einer Datei der Absturzwiederherstellung. Die Kopie aus Schritt 1 brachte jeden der acht Dienste in allen drei Durchgängen zurück, mit Eintrag A und ohne Eintrag B.
Was das für Ihren Server heißt
Machen Sie die Kopie aus Schritt 1 zur Gewohnheit vor jedem größeren Update. Sie kostete im Test 10 bis 15 Sekunden Stillstand, bei großen Datenordnern entsprechend länger, und den Platz für einen Ordner und ist der einzige Rückweg, der im Test bei allen acht Diensten funktionierte. Für Datenbanken wie MariaDB und PostgreSQL ist ein Dump vor dem Update eine weitere Möglichkeit, siehe Teil 1 der Reihe.
Halten Sie außerdem Updates und Zurückdrehen zeitlich eng zusammen. Je länger die neue Version läuft, desto mehr Daten gehen verloren, wenn Sie am Ende doch die Kopie zurückspielen müssen. Bei PostgreSQL gelten eigene Regeln für große Sprünge, die Teil 4 zeigt.
Typische Fehler
- Nextcloud:
downgrading is not supported Nextcloud startet nicht mit älterer Version auf neueren Daten. Spielen Sie die Kopie zurück wie in Schritt 3 oder bleiben Sie bei der neuen Version.
- Forgejo:
Forgejo will exit to keep your database safe and unchanged Die Datenbank wurde schon auf die neue Version migriert. Ändern Sie die Migrationsnummer nicht von Hand, wie die Meldung selbst warnt. Nehmen Sie die Kopie.
- Redis:
Can't handle RDB format version 15 Die Datei
dump.rdbstammt von einer neueren Redis-Version. Spielen Sie die alte Datei aus der Kopie zurück. Ist Redis ein reiner Zwischenspeicher, lässt sich die Datei stattdessen löschen. Dient Redis als Warteschlange, gehen dabei offene Aufgaben verloren.- MariaDB:
Recovery failed! You must enable all engines that were enabled at the moment of the crash Die ältere Version kam im Test mit der Datei
tc.lognicht zurecht, die die neuere hinterlassen hatte. Nehmen Sie die Kopie von vor dem Update.
Häufige Fragen
Gilt das Ergebnis für jeden Versionssprung?
Nein. Gemessen wurde je Dienst ein bestimmter Sprung, die Versionen stehen in der Tabelle. Laut Nextcloud-Dokumentation ist ein Downgrade dort grundsätzlich nicht vorgesehen. Verlassen Sie sich deshalb auf die Kopie, nicht auf Glück.
Reicht ein Snapshot des Dateisystems statt der Kopie?
Ja, wenn er bei gestopptem Dienst entsteht und den ganzen Datenordner erfasst. Er hat dann denselben Inhalt wie die Kopie aus Schritt 1. Gegen einen Plattenausfall schützt er nicht, weil er auf demselben Speicher liegt.
Fazit
Zurückdrehen per Tag ist bei der Hälfte der getesteten Dienste eine Sackgasse: Nextcloud, Forgejo, MariaDB und Redis starten mit der alten Version nicht mehr. Die anderen vier vertragen es, aber darauf sollte man nicht bauen. Eine Kopie des gestoppten Datenordners vor dem Update brachte im Test jeden Dienst zurück. Im nächsten Teil der Reihe geht es um den großen Versionssprung bei PostgreSQL.
Weiterführende Anleitungen und Quellen
- Ernstfall Teil 11: Zertifikat abgelaufen, Uhr falsch
- Ernstfall Teil 12: SQLite auf der Netzfreigabe
- Ernstfall Teil 13: Harter Abbruch
- Ernstfall Teil 2: Platte voll
- Ernstfall Teil 5: Container-Logs fluten die Platte
- Ernstfall Teil 6: down -v, prune, rm
- Ernstfall Teil 7: Angreifer kennt das Backup-Passwort
- Ernstfall Teil 8: Restore-Rennen
- Ernstfall Teil 9: Registry weg, Internet weg
- Ernstfall Teil 10: Admin-Passwort weg
- Ernstfall Teil 1: Datenbank im laufenden Betrieb kopiert
- Ernstfall Teil 4: PostgreSQL 16 auf 18 per Tag
- Docker-Container automatisch aktualisieren
- Docker und Docker Compose auf Linux installieren
- Nextcloud: Upgrade
- Forgejo: Upgrade guide
- MariaDB: Downgrading between major versions