Anleitungen: Künstliche Intelligenz
Künstliche Intelligenz verändert, wie wir arbeiten – vom automatisierten Kundenservice bis zur Code-Generierung. Hier findest du verständliche Anleitungen, aktuelle News und ehrliche Tool-Tests rund um KI im Unternehmens- und IT-Alltag. Ohne Hype, mit Fokus auf das, was in der Praxis wirklich funktioniert.
RAGFlow mit Docker installieren: Enterprise-RAG-Engine für eigene Wissensdatenbanken
RAGFlow per Docker Compose auf einem eigenen Linux-Server betreiben: Dokumente mit OCR und Chunking erschließen, Passwörter und Ports absichern, Wissensdatenbanken anlegen, Updates und Backups durchführen.
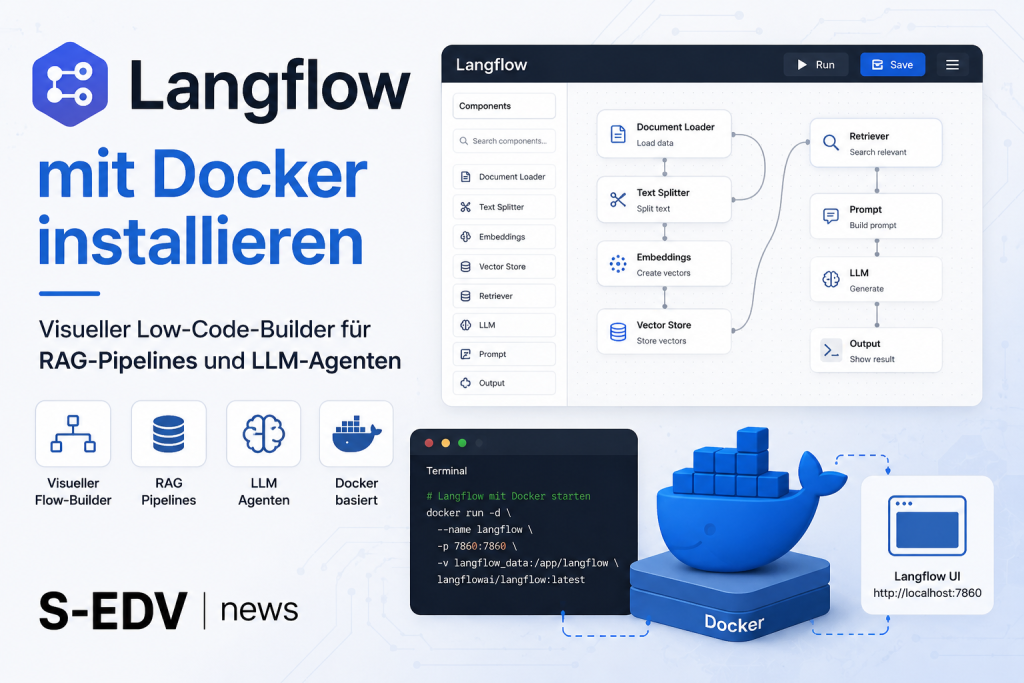
Langflow mit Docker installieren: Visueller Low-Code-Builder für RAG-Pipelines und LLM-Agenten
Langflow ist ein Open-Source-Builder mit Drag-and-Drop-Oberfläche für RAG-Pipelines und LLM-Agenten. Die Anleitung zeigt die Installation mit Docker Compose und PostgreSQL, feste Secrets, Reverse Proxy, Updates und Sicherung.
text-generation-webui mit Docker installieren: Umfassende Web-UI für lokale LLMs (llama.cpp, ExLlama, Transformers)
text-generation-webui betreibt lokale LLMs in den Formaten GGUF, GPTQ, AWQ und EXL2 mit optionaler OpenAI-kompatibler API. Die Anleitung zeigt den Docker-Weg vom Repository-Clone bis zum ersten Chat, mit Ports nur auf localhost und API-Key.
LiteLLM mit Docker installieren: Selbstgehosteter KI-Gateway für 100+ LLM-Provider
LiteLLM bündelt OpenAI, Anthropic, Ollama und weitere Provider hinter einer OpenAI-kompatiblen API. Die Anleitung richtet den Proxy mit Docker Compose, PostgreSQL, Virtual Keys und Kostenerfassung ein, mit festem Image-Tag und Verifizieren je Schritt.
Khoj mit Docker installieren: Selbstgehosteter KI-Assistent für eigene Notizen und Dokumente
Khoj ist ein selbst gehosteter KI-Assistent, der eigene PDFs, Markdown- und Word-Dateien indiziert und per Chat durchsuchbar macht, auf Wunsch vollständig lokal mit Ollama. Die Anleitung zeigt die Einrichtung per Docker Compose mit Prüfung nach jedem Schritt.
SillyTavern mit Docker installieren: Das Feature-reichste LLM-Frontend für Power-User
SillyTavern ist ein Open-Source-Frontend für Sprachmodelle. Die Anleitung zeigt die Docker-Installation mit compose.yaml und .env, Whitelist und Basic-Auth sowie die Anbindung an Ollama, OpenAI und weitere Backends.
Tabby mit Docker installieren: Selbstgehosteter KI-Coding-Assistent als Copilot-Ersatz
Tabby ist ein selbst gehosteter KI-Coding-Assistent für VS Code und JetBrains-IDEs. Die Anleitung zeigt die Einrichtung mit Docker Compose, fester Version, GPU- oder CPU-Betrieb, lokal gebundenem Port und IDE-Anbindung.
DeepSeek lokal betreiben: R1-Modelle mit Ollama, Modellwahl und VRAM-Bedarf
DeepSeek lokal nutzen: welche R1-Variante zu welcher GPU passt, warum DeepSeek V4 nur in der Cloud läuft und wie Sie Ollama 0.35 per Docker mit Kontext, Denkausgabe und Modelfile einrichten.
Qwen3 lokal betreiben: 4B bis 32B per Ollama und vLLM mit Thinking-Mode
Qwen3 lokal per Ollama oder vLLM betreiben: Modellwahl nach VRAM, Thinking-Mode per /set nothink, think-Parameter oder enable_thinking steuern, vLLM-API mit Reasoning-Parser und YaRN für langen Kontext.
Microsoft Phi-4 lokal betreiben: 14B Reasoning-Modell auf Consumer-GPU
Phi-4 von Microsoft liegt auf Mathe- und Reasoning-Benchmarks vor GPT-4o und läuft per Ollama, Microsoft Foundry Local oder llama.cpp auf einer RTX 3080. Die Anleitung zeigt alle drei Wege, die Quantisierungswahl für 8 bis 12 GB VRAM und typische Fehler.