Platte voll: Welcher Dienst stirbt zuerst und wie Sie zurückkommen
Ernstfall Teil 2: Sechs Dienste auf einer vollen Platte. Nextcloud sagte schon bei 64 MB Rest Nein, PostgreSQL schrieb noch 36 bis 50 Sekunden weiter. Nach dem Freiräumen schrieben alle ohne Neustart weiter, ein Neustart bei voller Platte legte PostgreSQL still.
Mit KI erstellt – redaktionelle Prüfung ausstehend
Werbung Mit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Irgendwann ist die Platte voll. Ein Upload zu viel, ein Backup, das nicht aufräumt, Logs ohne Grenze. Auf einem Server mit Docker teilen sich dann alle Dienste denselben knappen Platz, und jeder geht anders damit um. Für diese Anleitung liefen PostgreSQL, MariaDB, Redis, Forgejo, ntfy und Nextcloud gemeinsam auf einer absichtlich kleinen Platte, während eine Datei sie Stück für Stück füllte. Gemessen wurde, wann welcher Dienst scheitert, was ein Neustart bei voller Platte anrichtet und wie die Dienste zurückkommen.
Dies ist Teil 2 der Reihe „Ernstfall“. Jeder Teil macht absichtlich etwas kaputt, misst, was passiert, und zeigt den Weg zurück.
Was Sie brauchen
- Einen Linux-Server mit Docker und Docker Compose, siehe Docker und Docker Compose auf Linux installieren.
- Root-Rechte auf dem Host zum Suchen und Löschen großer Dateien.
- Für Schritt 3 die Namen Ihrer Datenbank-Dienste in der
compose.yaml, in den Beispielenpgundmaria.
Schritt 1: Nachsehen, wo der Platz geblieben ist
Ob die Platte voll ist, zeigt df. Docker legt Images, Container und Volumes unter /var/lib/docker ab, Bind-Mounts liegen dort, wo Ihre compose.yaml sie hinlegt:
$ df -h / /var/lib/docker
$ sudo du -xh --max-depth=1 /var/lib/docker | sort -h | tail -5
$ docker system df
Gehen Sie von dort in den größten Ordner, bis Sie die Ursache haben. Typisch sind Logdateien ohne Grenze (siehe Teil 5 der Reihe), alte Images und Sicherungen, die auf derselben Platte liegen.
Verifizieren: Sie kennen die Datei oder den Ordner, der den Platz belegt, und wissen, ob Sie ihn gefahrlos löschen können.
Schritt 2: Platz schaffen, ohne Dienste neu zu starten
Löschen Sie zuerst, was die Platte gefüllt hat, und starten Sie dabei nichts neu. Das ist die wichtigste Regel dieses Teils: Im Test schrieben alle sechs Dienste nach dem Freiräumen ohne Neustart wieder, fünf schon bei der ersten Probe, ntfy nach gut drei Sekunden. Ein Neustart bei voller Platte dagegen legte PostgreSQL still.
Prüfen Sie danach, ob alle Container laufen:
$ docker compose ps -aVerifizieren: df -h zeigt wieder Platz, und kein Dienst steht auf Exited.
Schritt 3: Datenbanken nach einem Neustart zurückholen
Steht eine Datenbank nach einem Neustart bei voller Platte auf Exited, starten Sie sie nach dem Freiräumen von Hand. Ohne restart-Regel in der compose.yaml tut das niemand für Sie. Im Test lief dafür ein Neustart aller Dienste, für einzelne genügt:
$ docker compose up -d pg mariaPrüfen Sie danach die Daten mit dem Werkzeug der Datenbank, so wie im Test:
$ docker compose exec -T pg pg_amcheck -U postgres -d probe --install-missing --heapallindexed
$ docker compose exec -T maria sh -c 'mariadb-check -uroot -p"$MARIADB_ROOT_PASSWORD" probe'
Verifizieren: pg_amcheck endet mit dem Rückgabewert 0, mariadb-check meldet für jede Tabelle OK. Im Test war das nach allen drei Durchgängen der Fall.
So wurde gemessen
Getestet mit PostgreSQL 18.7, MariaDB 11.8.9, Redis 8.10.3 mit AOF, Forgejo 17.0.1 mit SQLite, ntfy 2.38.0 mit Nachrichten-Cache und Nextcloud 35.0.3 mit SQLite, unter Docker 29.8.2 und Docker Compose 5.5.1. Alle sechs Dienste legten ihre Daten auf dieselbe 1 GB große Platte, eine RAM-Disk als Docker-Volume. Voll lief also nur diese Platte, nicht das System des Testrechners.
Jeder Dienst bekam immer wieder kleine Schreibaufträge von 3 bis 6 KB: eine Zeile in eine Tabelle, einen Eintrag in eine Redis-Liste, ein Ticket in Forgejo, eine Nachricht in ntfy, eine Datei in Nextcloud. Gezählt wurde, welche Aufträge der Dienst bestätigte. Dann füllten Dateien die Platte in Schritten, bis kein Byte mehr frei war, und die Platte blieb zwei Minuten voll. Danach wurde die Füllung gelöscht, ohne einen Dienst anzufassen. Dann wurde die Platte erneut gefüllt, alle Dienste wurden bei voller Platte neu gestartet, die Füllung wieder gelöscht und zum Schluss alle neu gestartet und geprüft. Das Ganze lief dreimal mit frischen Daten, mit demselben Ablauf in jeder Runde. Ein früherer Lauf mit anderem Ablauf ergänzt die Beobachtungen zum Neustart von MariaDB und PostgreSQL.
Ergebnis 1: Wer wann scheitert
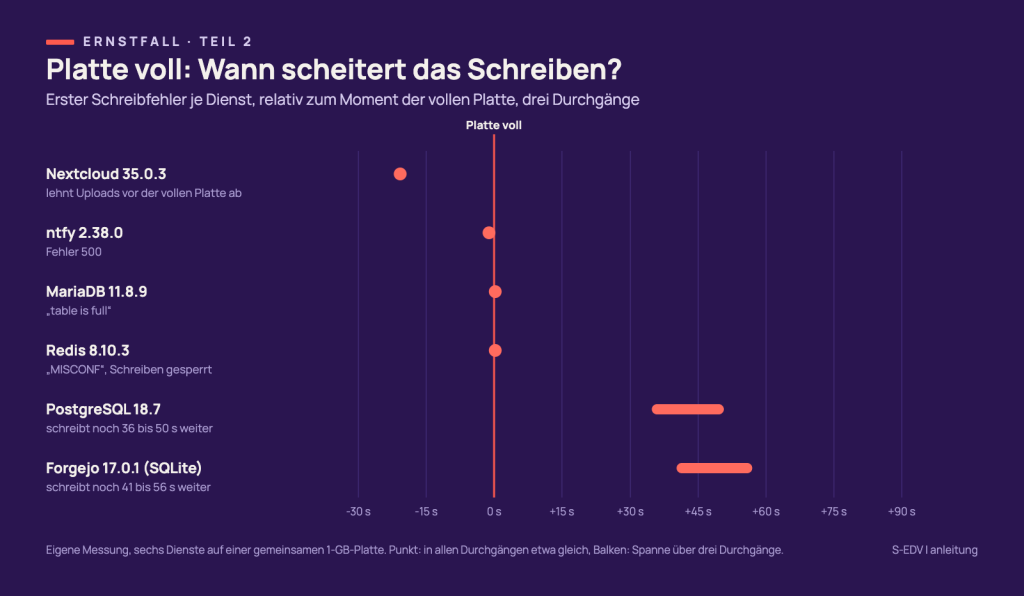
Nextcloud verweigerte Uploads schon, als noch 64 MB frei waren, mit HTTP 507 und der Meldung Sabre\DAV\Exception\InsufficientStorage. Bei der Messung davor, mit rund 104 MB frei, nahm es noch an. Beim zweiten Füllen kam die Ablehnung schon bei rund 94 MB frei. Bei ganz voller Platte kam dann erst HTTP 503, danach HTTP 500, und auch das Auflisten der Dateien scheiterte.
MariaDB, Redis und ntfy scheiterten im selben Moment wie die Platte. MariaDB meldete ERROR 1114 (HY000) at line 1: The table 't' is full, Redis sperrte jedes Schreiben mit MISCONF Errors writing to the AOF file: No space left on device, ntfy antwortete mit internal server error.
PostgreSQL und Forgejo schrieben noch erstaunlich lange weiter, PostgreSQL 36 bis 50 Sekunden, Forgejo 41 bis 56 Sekunden. Dann kam bei PostgreSQL could not extend file … No space left on device und bei Forgejo database or disk is full. Lesen funktionierte bei voller Platte bei PostgreSQL, MariaDB, Redis und Forgejo. Bei Nextcloud scheiterte das Auflisten, bei ntfy die Abfrage an derselben Bremse für zu viele Anfragen.
Ergebnis 2: Freiräumen hilft, ein Neustart nicht
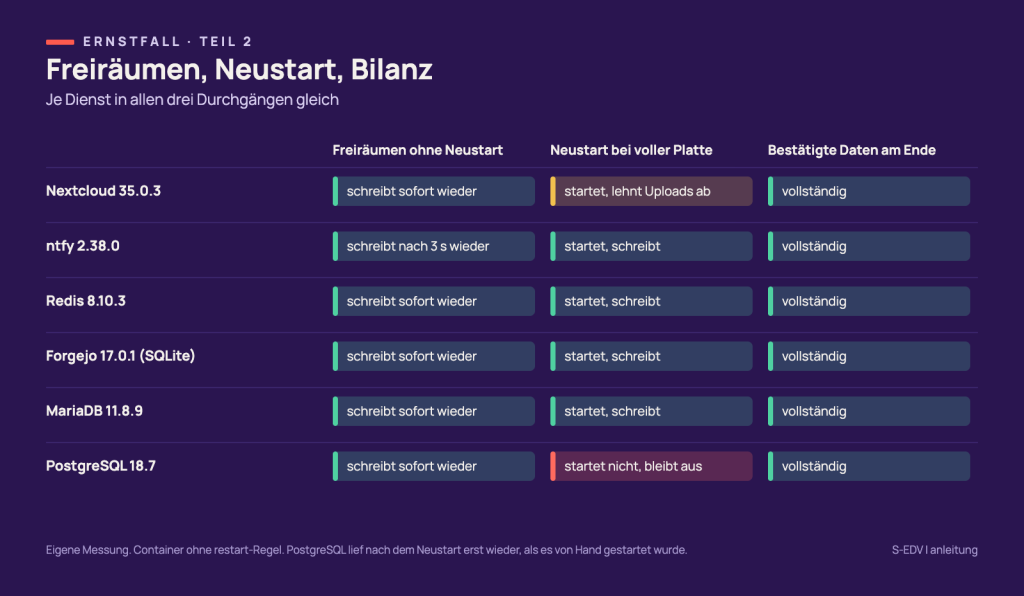
Nach dem Löschen der Füllung, ohne einen Dienst anzufassen, gelang bei fünf Diensten schon die erste Schreibprobe, auch Redis hob seine Sperre ohne Eingriff auf. ntfy schrieb in zwei Durchgängen erst nach gut drei Sekunden wieder. Das lag nicht an der Platte, sondern an seiner eingebauten Bremse für zu viele Anfragen, die einen Teil der Proben mit HTTP 429 abwies, auch schon während die Platte voll war.
Ein Neustart der Container bei voller Platte, wie ihn ein Update oder ein Neustart des Servers auslöst, trennte die Dienste. Redis, Forgejo, ntfy und MariaDB starteten und schrieben weiter, Nextcloud startete und lehnte Uploads weiter ab. PostgreSQL startete nicht. Es brach beim Herunterfahren mit einem PANIC ab und konnte danach seine Dateien nicht schreiben:
PANIC:  could not write to file "pg_logical/replorigin_checkpoint.tmp": No space left on device
FATAL:  could not write to file "pg_wal/xlogtemp.32": No space left on device
Auch nachdem wieder rund 730 MB frei waren, blieb PostgreSQL aus. Erst ein Start von Hand brachte es zurück, fehlerfrei. In einem früheren Lauf mit anderem Ablauf, in dem bei voller Platte zusätzlich Zeilen gelöscht wurden und die Dienste nach zwei Minuten voller Platte neu starteten, scheiterte auch MariaDB beim Start mit Plugin 'InnoDB' registration as a STORAGE ENGINE failed und Aborting, PostgreSQL zusätzlich mit could not write lock file "postmaster.pid".
Die Bilanz am Ende: Bei allen sechs Diensten waren in allen drei Durchgängen alle bestätigten Einträge vorhanden, bei PostgreSQL 117 von 117, bei MariaDB 88 von 88. pg_amcheck, mariadb-check und für Forgejo PRAGMA integrity_check fanden keinen Schaden. Was ein Dienst bei voller Platte abgelehnt hatte, fehlte natürlich.
Was das für Ihren Server heißt
Die Reihenfolge entscheidet. Erst Platz schaffen, dann neu starten. Ein Server, der bei voller Platte neu startet, dürfte nach diesem Ergebnis im ungünstigen Fall ohne Datenbank zurückkommen.
Setzen Sie für Datenbanken eine restart-Regel wie unless-stopped. Dann versucht Docker den Start laut Dokumentation immer wieder, mit wachsenden Pausen dazwischen. Die Regel greift laut Dokumentation aber erst, wenn ein Container schon einmal mindestens zehn Sekunden lief. Im Test hatten die Container keine solche Regel. Und überwachen Sie den freien Platz, bevor es eng wird. Nextcloud hat gezeigt, dass ein Dienst rechtzeitig Nein sagen kann. Ein Monitoring, das bei 80 Prozent warnt, gibt Ihnen dieselbe Chance für den ganzen Server.
Typische Fehler
- MariaDB:
ERROR 1114 (HY000): The table '…' is full Die Tabelle ist nicht zu groß, die Platte ist voll. Schaffen Sie Platz wie in Schritt 2, MariaDB schrieb danach im Test ohne Neustart weiter.
- Redis:
MISCONF Errors writing to the AOF file: No space left on device Redis sperrt Schreibzugriffe, um die Daten nicht zu gefährden. Nach dem Freiräumen hob es die Sperre im Test von selbst auf.
- PostgreSQL:
PANIC: could not write to file "pg_logical/replorigin_checkpoint.tmp" PostgreSQL wurde bei voller Platte gestoppt und konnte danach nicht wieder starten. Schaffen Sie Platz und starten Sie den Container wie in Schritt 3.
- Nextcloud:
HTTP 507,InsufficientStorage, obwohl noch Platz ist Nextcloud nimmt Uploads nur an, solange genug Platz bleibt. Im Test lehnte es bei rund 94 MB frei ab und nahm bei rund 104 MB noch an.
- Forgejo:
database or disk is full Die Meldung kommt von SQLite. Nach dem Freiräumen arbeitete Forgejo im Test ohne Neustart weiter.
Häufige Fragen
Hilft eine restart-Regel?
Sie sorgt dafür, dass Docker eine abgestürzte Datenbank immer wieder startet. Platz schaffen müssen Sie trotzdem selbst.
Gilt das auch, wenn die Systemplatte voll ist?
Ist die Systemplatte voll, kommen Probleme mit Anmeldung, Paketverwaltung und Systemprotokollen dazu.
Fazit
Eine volle Platte ist für die meisten Dienste kein Datenverlust, sondern ein Stillstand, und der endet, sobald wieder Platz ist. Nach dem Freiräumen schrieben alle sechs Dienste weiter, ohne dass jemand eingreifen musste. Riskant war nur der Neustart bei voller Platte: PostgreSQL fiel dabei aus und blieb aus, bis jemand nachsah. Wer zuerst aufräumt und dann neu startet, kam im Test bei allen sechs Diensten ohne Verlust zurück. Im nächsten Teil der Reihe wird ein Update zurückgedreht.
Weiterführende Anleitungen und Quellen
- Ernstfall Teil 11: Zertifikat abgelaufen, Uhr falsch
- Ernstfall Teil 12: SQLite auf der Netzfreigabe
- Ernstfall Teil 13: Harter Abbruch
- Ernstfall Teil 1: Datenbank im laufenden Betrieb kopiert
- Ernstfall Teil 3: Update zurückdrehen
- Ernstfall Teil 4: PostgreSQL 16 auf 18 per Tag
- Ernstfall Teil 6: down -v, prune, rm
- Ernstfall Teil 7: Angreifer kennt das Backup-Passwort
- Ernstfall Teil 8: Restore-Rennen
- Ernstfall Teil 9: Registry weg, Internet weg
- Ernstfall Teil 10: Admin-Passwort weg
- Ernstfall Teil 5: Container-Logs fluten die Platte
- Docker und Docker Compose auf Linux installieren
- Docker Compose absichern
- PostgreSQL: Monitoring Disk Usage
- MariaDB: How MariaDB handles a full disk
- Redis: Persistence
- Docker: Start containers automatically