Anleitungen aus der Praxis
Getestete Schritt-für-Schritt-Anleitungen aus realen Kundenumgebungen — sicher, dokumentiert, nachvollziehbar.
Strukturierte JSON-Ausgaben aus lokalen LLMs: Grammar-Constraints und JSON-Mode für zuverlässige Automatisierungen
Lokale LLMs liefern ohne Vorgaben oft unzuverlässige Ausgaben. Mit Grammar-Sampling in llama.cpp und dem JSON-Schema-Mode von Ollama erzwingen Sie exakt strukturierte JSON-Antworten für PowerShell-Skripte, n8n-Workflows und Python, ohne manuelle Nachbearbeitung.
Open WebUI absichern: Benutzergruppen, RBAC und Modell-Zugriffssteuerung für den KI-Firmen-Chat
Open WebUI bringt Rollen, Gruppen, granulare Berechtigungen und SSO mit. So machen Sie aus dem Einzel-Admin-Tool eine abgesicherte Team-Plattform, auf der jeder Mitarbeiter nur die Modelle und Funktionen nutzt, die er braucht.
CUDA-Umgebung korrekt aufsetzen: Treiber, Toolkit, cuDNN und PyTorch auf Ubuntu
Treiber zuerst, dann PyTorch mit dem passenden CUDA-Paket, Toolkit und cuDNN nur bei Bedarf: So richten Sie auf Ubuntu Server eine CUDA-Umgebung mit PyTorch 2.14, CUDA 13 und Treiberzweig 580 ein und prüfen jede Schicht einzeln.
GGUF, AWQ und GPTQ erklärt: Welches Quantisierungsformat für welchen Zweck
GGUF, AWQ und GPTQ im Vergleich: welches Quantisierungsformat zu CPU, Apple Silicon, NVIDIA- oder AMD-GPU passt, mit Befehlen für Ollama, llama.cpp, vLLM und aktuellen Quantisierungswerkzeugen.
Langfuse selbst hosten: LLM-Observability und Audit-Logging für KI-Anwendungen
Langfuse ist die selbst gehostete Observability-Plattform für LLM-Anwendungen: vollständige Traces, Kosten- und Qualitätsmetriken sowie DSGVO-konformes Audit-Logging – als logische Ergänzung zu LiteLLM-Proxy und Ollama.
OpenHands Agent Canvas mit Docker und Ollama selbst betreiben
OpenHands Agent Canvas 1.24 per Docker Compose mit Ollama betreiben: Ordnerrechte für UID 10001, API-Schutz über OH_SESSION_API_KEYS_0, Zugriff per SSH-Tunnel und Modellanbindung mit großem Kontextfenster.
Open WebUI erweitern: Tools, Functions und Pipelines selbst bauen und einbinden
Open WebUI mit eigenen Python-Tools und Filter-Functions erweitern: GLPI-Ticket-Tool, SearXNG-Suche, PII-Filter, Pipelines als Legacy einordnen und sicher betreiben.
Letta App Server selbst hosten: KI-Agenten mit Langzeitgedächtnis per Docker
Der alte Letta-Server ist eingestellt: So betreiben Sie den Letta App Server 0.34 per Docker Compose mit Token-Schutz, OpenAI-kompatibler API, lokalem Agentengedächtnis (MemFS), Ollama-Anbindung und Backup.
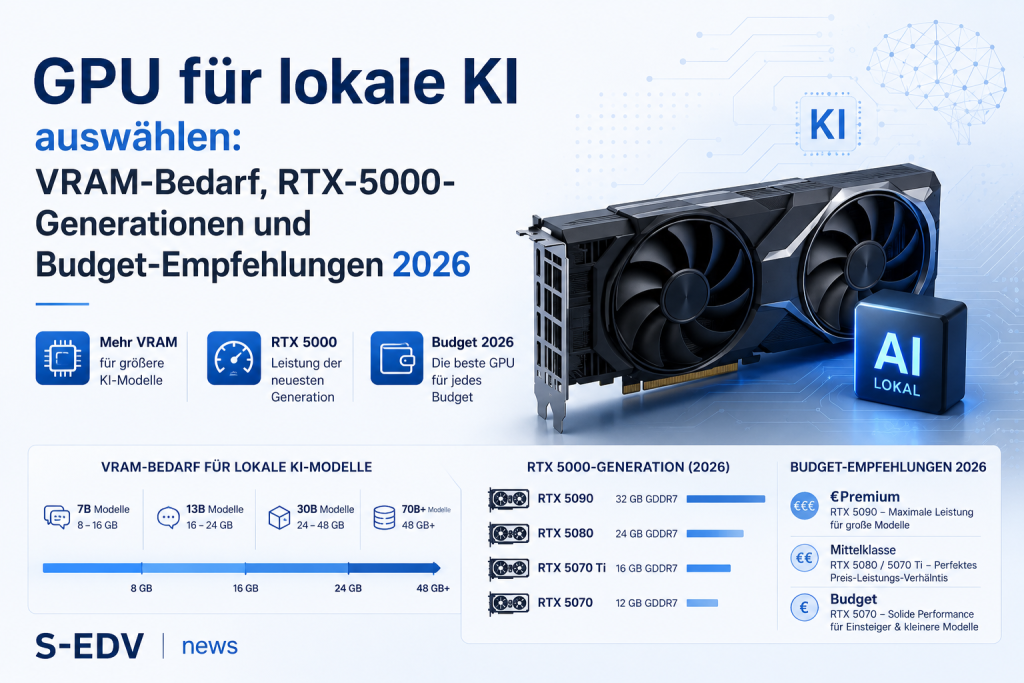
GPU für lokale KI auswählen: VRAM-Bedarf, RTX-5000-Generationen und Budget-Empfehlungen 2026
Welche GPU reicht für welches Sprachmodell? Diese Anleitung erklärt die VRAM-Kalkulator-Logik, liefert gemessene Werte für aktuelle LLMs und gibt konkrete Kaufempfehlungen von RTX 5060 bis RTX 5090 – ehrlich mit echten Straßenpreisen und typischen Fallstricken.
Windows LAPS mit Entra ID und Intune: Lokale Adminpasswörter sicher verwalten
Windows LAPS rotiert lokale Administratorpasswörter auf allen Windows-Clients automatisch und speichert sie sicher in Entra ID – ausrollbar via Intune ohne zusätzliche Software. Lateral-Movement-Angriffe verlieren damit ihre wichtigste Grundlage.