VoiceStudio 0.5.6 mit Docker: lokale ElevenLabs-Alternative selbst hosten
VoiceStudio 0.5.6 per Docker Compose installieren, Stimme klonen und Sprache erzeugen, alles lokal. Mit API-Key, Backup, Updates und echten Messwerten auf CPU.
Geprüft am 17.10.2026 · für VoiceStudio 0.5.6
Mit KI erstellt – redaktionelle Prüfung ausstehend
WerbelinksMit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
VoiceStudio ist eine quelloffene Plattform für Text zu Sprache, Stimmklon, Sprachdesign und Videosynchronisation, die vollständig auf Ihrem eigenen Server läuft. Wer Ansagen für Telefonanlagen, Schulungsvideos oder Hörfassungen von Dokumenten erzeugen will, ohne Texte und Stimmproben an einen Cloud-Dienst wie ElevenLabs zu schicken, bekommt damit eine lokale Alternative. Diese Anleitung zeigt die Installation von Version 0.5.6 mit Docker Compose, so wie wir sie auf einem Testserver ohne Grafikkarte nachvollzogen haben, inklusive echter Messwerte zu Laufzeit und Speicherbedarf.
Voraussetzungen
VoiceStudio ist ressourcenhungrig. Planen Sie den Server nach diesen Werten, die sich aus Dokumentation und Test ergeben:
- Architektur: x86-64 (linux/amd64). Das Projekt veröffentlicht keine ARM64-Images, ein Raspberry Pi oder ein ARM-VPS scheidet für den Docker-Weg aus.
- RAM: mindestens 8 GB, besser 12 GB oder mehr. Im Leerlauf belegte der Container rund 1,9 GB, während der Generierung bis zu 6,5 GB.
- CPU: mindestens 4 Kerne. Der Test lief auf 14 Kernen, die Synthese lastete etwa sieben davon aus.
- Speicher: rund 20 GB frei. Das Image ist 5,7 GB groß, das Pflichtmodell belegt im Volume etwa 3,1 GB, weitere Modelle für Transkription oder Übersetzung kommen bei Bedarf hinzu. VoiceStudio selbst verlangt mindestens 10 GB freien Platz im Modell-Cache.
- GPU (optional, empfohlen): NVIDIA-Karte mit NVIDIA Container Toolkit oder AMD-Karte mit amdgpu-Treiber und dem separaten ROCm-Image. Ohne Grafikkarte funktioniert alles, aber deutlich langsamer.
- Software: Docker Engine mit Compose-Plugin, Python 3 zum Erzeugen des API-Keys, ein aktueller Browser.
- Netz: Internetzugang beim ersten Start für das Modell von Hugging Face.
Schritt 1: Projektordner, API-Key und Compose-Datei anlegen
Das Projekt liefert unter deploy/docker-compose.yml eine Datei mit fünf Profilen (cpu, gpu, rocm, worker-gpu, worker-rocm). Sie verweist auf das Image :latest, das laut Dokumentation eine rollierende Vorschau aus dem Hauptzweig ist, und enthält einen build:-Block, der den kompletten Quellcode voraussetzt. Für einen Server ist eine schlanke eigene Datei übersichtlicher: ein Dienst, fester Release-Tag, kein Build, keine Profile.
mkdir -p /opt/voicestudio && cd /opt/voicestudio
umask 077
echo "OMNIVOICE_API_KEY=$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')" > .env
Der Key ist das Administrator-Passwort der Instanz. Bewahren Sie ihn in Ihrem Passwortmanager auf. Legen Sie dann die compose.yaml an:
services:
  voicestudio:
    image: ghcr.io/debpalash/omnivoice-studio:0.5.6
    ports:
      - "127.0.0.1:3900:3900"
    volumes:
      - omnivoice-data:/app/omnivoice_data
    environment:
      - HF_HOME=/app/omnivoice_data/huggingface
      - HF_TOKEN=${HF_TOKEN:-}
      - OMNIVOICE_DATA_DIR=/app/omnivoice_data
      - OMNIVOICE_BIND_HOST=0.0.0.0
      - OMNIVOICE_SERVER_MODE=1
      - OMNIVOICE_API_KEY=${OMNIVOICE_API_KEY:?OMNIVOICE_API_KEY in .env setzen}
    healthcheck:
      test: ["CMD", "curl", "-sf", "http://localhost:3900/health"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 120s
    restart: unless-stopped

volumes:
  omnivoice-data:
Die Umgebungsvariablen entsprechen dem CPU-Profil der Upstream-Datei. OMNIVOICE_SERVER_MODE=1 ist nötig, weil das Backend hinter dem Docker-NAT nicht erkennen kann, ob ein Browser lokal sitzt; Verwaltungsfunktionen verlangen deshalb den API-Key. Die Variablen für den Remote-Worker (Port 7443) haben wir weggelassen, weil sie nur für verteilte GPU-Worker gebraucht werden. Wer statt GitHub Container Registry lieber Docker Hub nutzt, schreibt palashdeb/omnivoice-studio:0.5.6; laut Projekt sind beide Images identisch, der Digest von 0.5.6 und stable stimmte bei unserer Prüfung überein.
Verifizieren: docker compose config --quiet gibt nichts aus. Fehlt der Key in der .env, bricht Compose sofort ab mit required variable OMNIVOICE_API_KEY is missing a value: OMNIVOICE_API_KEY in .env setzen.
Schritt 2: Container starten
docker compose pull
docker compose up -d
docker compose ps
Der Download des 5,7 GB großen Images dauerte im Test fünf Minuten. Danach war der Container nach rund zwölf Sekunden healthy. Beim ersten Start legt VoiceStudio die SQLite-Datenbank an, spielt elf Migrationen ein, sichert die Datenbank vorher automatisch als omnivoice.db.backup-0.5.6-1 und legt eine Demostimme an.
curl -s http://127.0.0.1:3900/health
{"status":"ok","device":"cpu","version":"0.5.6"}
Verifizieren: docker compose ps zeigt Up (healthy), /health meldet Version 0.5.6 und das genutzte Gerät (cpu, cuda oder bei Apple mps). In docker compose logs steht am Ende Deferred startup complete — all routes live.
Schritt 3: Anmelden und Sprachmodell laden
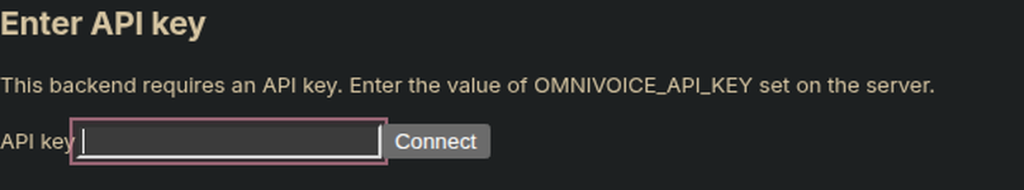
Öffnen Sie http://127.0.0.1:3900 auf dem Server selbst oder über einen SSH-Tunnel (ssh -L 3900:127.0.0.1:3900 server). Die Oberfläche fragt zuerst nach dem API-Key. Sie tauscht ihn gegen eine Sitzung von acht Stunden (Cookie ov_session, HttpOnly, SameSite strict) und speichert den Key selbst nicht.
Danach folgen drei kurze Fragen: UI-Skalierung, ob anonyme Nutzungsstatistiken gesendet werden dürfen (Voreinstellung: nichts wird gesendet, bis Sie zustimmen) und die Sprache. Die Oberfläche erkennt Deutsch automatisch aus dem Browser.
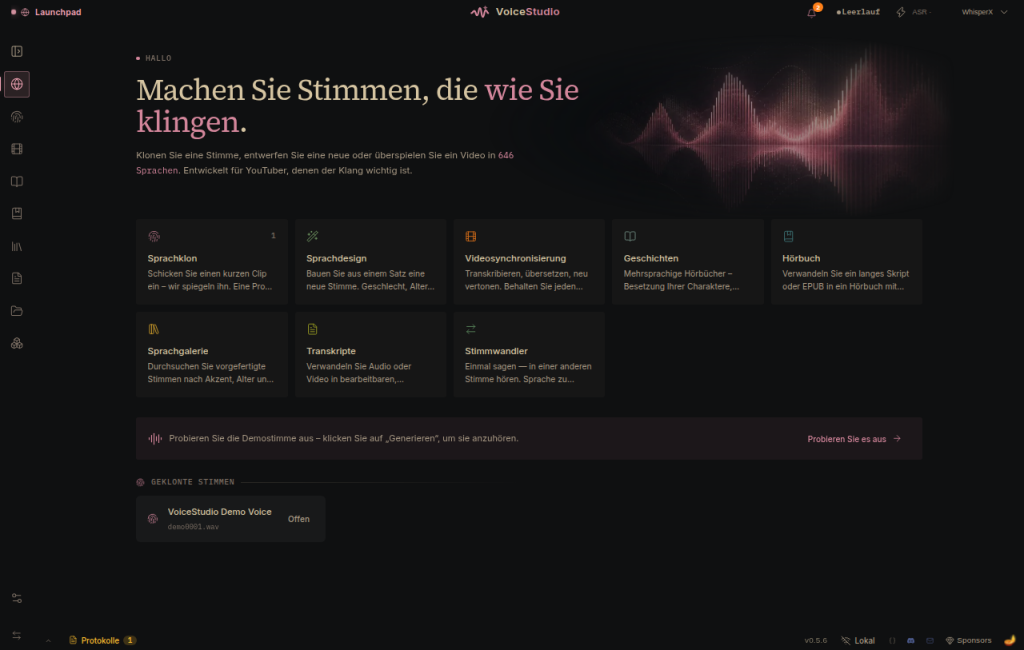
Das Pflichtmodell k2-fsa/OmniVoice ist nicht im Image enthalten. Ohne Modell meldet der Start im Log Preload skipped: k2-fsa/OmniVoice is not installed locally. Wir haben den Download direkt über die API angestoßen, das funktioniert auch ohne Browser:
set -a; . ./.env; set +a
curl -s -H "Authorization: Bearer $OMNIVOICE_API_KEY" -H "Content-Type: application/json" \
  -d '{"repo_id":"k2-fsa/OmniVoice","target":"local"}' http://127.0.0.1:3900/models/install
curl -s -H "Authorization: Bearer $OMNIVOICE_API_KEY" http://127.0.0.1:3900/models/install/status
Die 13 Dateien mit zusammen 3,27 GB waren im Test nach gut vier Minuten geladen. Das Modell liegt im Volume unter huggingface/ und übersteht damit Neustarts und Updates.
Verifizieren: curl -s -H "Authorization: Bearer $OMNIVOICE_API_KEY" http://127.0.0.1:3900/setup/status liefert "models_ready":true und eine leere Liste missing.
Schritt 4: Stimme klonen und Sprache erzeugen
In der Ansicht Stimme wählen Sie den Reiter Aus Audio, laden eine Referenzaufnahme hoch (das Programm empfiehlt 5 bis 15 Sekunden klare Sprache) und geben möglichst den gesprochenen Text der Aufnahme mit an. Für unseren Test haben wir statt einer echten Stimme eine synthetische Aufnahme mit espeak-ng erzeugt, 6 Sekunden lang. Über die API sieht derselbe Schritt so aus:
curl -s -H "Authorization: Bearer $OMNIVOICE_API_KEY" \
  -F name=Testsprecher -F kind=clone -F language=German \
  -F "ref_text=Guten Tag. Dies ist eine Testaufnahme." \
  -F ref_audio=@referenz.wav http://127.0.0.1:3900/profiles

curl -s -D kopf.txt -o ansage.wav -H "Authorization: Bearer $OMNIVOICE_API_KEY" \
  -F "text=Willkommen bei S-EDV. Diese Ansage wurde lokal erzeugt." \
  -F language=German -F profile_id=PROFIL-ID http://127.0.0.1:3900/generate
Die Antwort auf /profiles enthält die id des neuen Profils. /generate liefert eine WAV-Datei und in den Kopfzeilen X-Gen-Time und X-Audio-Duration. Daneben gibt es eine OpenAI-kompatible Schnittstelle unter /v1/audio/speech, sodass vorhandene Skripte mit geänderter Basis-URL weiterarbeiten können.
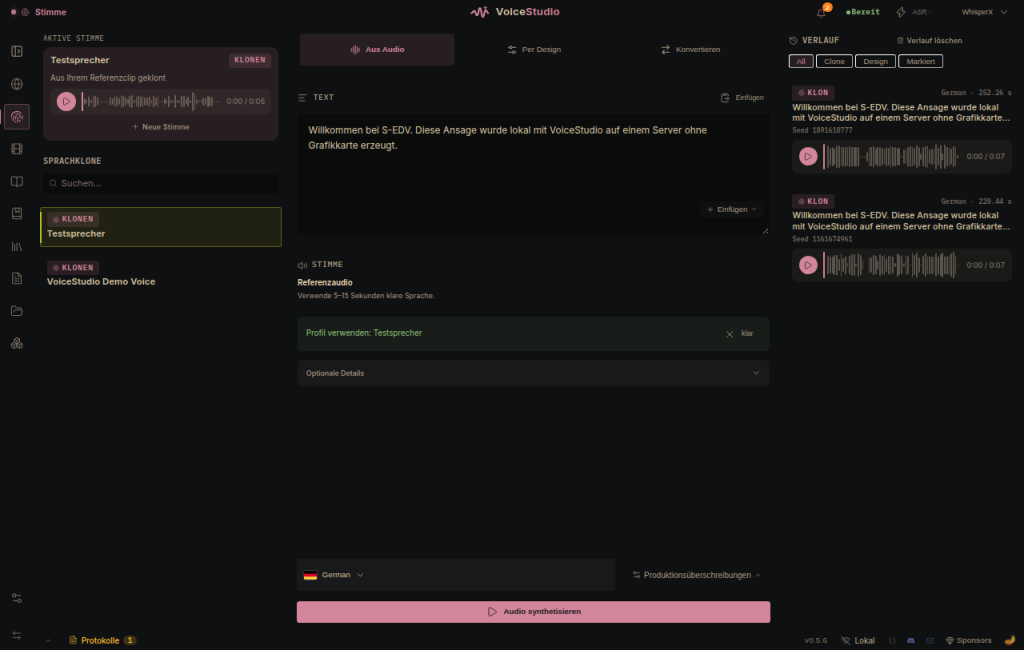
Die Messwerte auf CPU ohne Grafikkarte: Die erste Generierung eines Satzes mit 7,47 Sekunden Audio brauchte 220 Sekunden, davon rund vier Sekunden zum Laden des Modells und einige Sekunden für das einmalige Laden des AudioSeal-Wasserzeichenmodells. Die zweite Generierung desselben Textes dauerte 252 Sekunden. Auf CPU ist also mit etwa dem 30-fachen der Audiolänge zu rechnen. Der Arbeitsspeicher stieg von 1,9 GB auf bis zu 6,5 GB. Für kurze Ansagen ist das brauchbar, für Hörbücher oder Videos nicht. VoiceStudio bettet in jede Ausgabe ein unhörbares AudioSeal-Wasserzeichen ein; im Log erscheint das als eigene Stufe watermark der Verarbeitung.
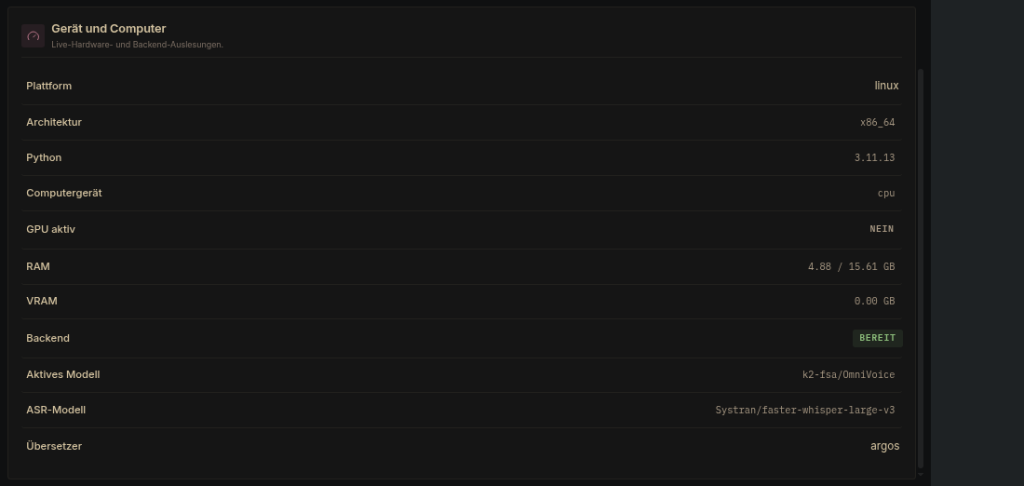
Verifizieren: ffprobe ansage.wav zeigt pcm_s16le, 24000 Hz, Mono und die erwartete Dauer. Unter Einstellungen, Leistung und Gerät steht bei Computergerät cpu oder Ihr GPU-Typ.
Schritt 5: GPU nutzen
Laut Dokumentation genügt für NVIDIA-Karten das NVIDIA Container Toolkit auf dem Host und ein Geräteeintrag im Dienst:
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
AMD-Karten brauchen das eigene Image ghcr.io/debpalash/omnivoice-studio:0.5.6-rocm und die Gerätedateien /dev/kfd und /dev/dri unter devices:. Das Standard-Image ist ein CUDA-Build und rechnet auf AMD-Hardware nur mit der CPU. Den Projektangaben zufolge sind auf GPU mehrere Generierungen parallel möglich, auf CPU immer nur eine.
Verifizieren: curl -s http://127.0.0.1:3900/health meldet "device":"cuda", und in der Oberfläche steht bei GPU aktiv JA. Bleibt dort cpu, nennt die Logzeile Falling back to CPU: den Grund.
Schritt 6: Zugriff im LAN und per Reverse Proxy
Die Compose-Datei bindet Port 3900 nur an 127.0.0.1. Im Test war die Oberfläche über die LAN-Adresse des Servers nicht erreichbar, über Loopback schon. Das ist so gewollt. Die Upstream-Dokumentation beschreibt für das LAN das Ändern auf "0.0.0.0:3900:3900", warnt aber gleichzeitig: Über unverschlüsseltes HTTP laufen API-Key und Sitzungscookie im Klartext durchs Netz. Öffnen Sie den Port deshalb nicht direkt, auch nicht im Firmennetz, und schon gar nicht ins Internet.
Besser ist ein Reverse Proxy mit HTTPS auf demselben Host, der auf 127.0.0.1:3900 weiterleitet. Mit Caddy reicht ein Eintrag:
voice.example.de {
    reverse_proxy 127.0.0.1:3900
}
VoiceStudio wertet X-Forwarded-Proto: https aus und setzt das Sitzungscookie dann mit dem Attribut Secure. Hinter unserem Test-Proxy mit HTTPS war das so. Liegen Oberfläche und API auf verschiedenen Adressen, setzen Sie OMNIVOICE_PUBLIC_API_BASE auf die öffentliche API-URL. Für Zugriffe von unterwegs empfiehlt das Projekt ein verschlüsseltes privates Netz wie Tailscale statt einer öffentlichen Freigabe.
Verifizieren: curl -I https://voice.example.de/health liefert 200, ein Aufruf von /setup/status ohne Key über den Proxy liefert 401.
Schritt 7: Sichern und wiederherstellen
Alle Nutzdaten liegen im Volume: Datenbank mit Stimmprofilen und Verlauf, Referenzclips, erzeugte Dateien und Einstellungen. Das Modell im Unterordner huggingface lässt sich jederzeit neu laden und muss nicht ins Backup. Stoppen Sie den Container, damit die SQLite-Datenbank konsistent ist:
docker compose stop
docker run --rm -v voicestudio_omnivoice-data:/data:ro -v "$PWD":/backup alpine:3.22 \
  tar czf /backup/voicestudio-daten.tar.gz --exclude=./huggingface -C /data .
docker compose start
Der Volumename setzt sich aus dem Ordnernamen und omnivoice-data zusammen, docker volume ls zeigt ihn. Ohne Modell war das Archiv im Test nur 1 MB groß. Für die Wiederherstellung:
docker compose stop
docker run --rm -v voicestudio_omnivoice-data:/data -v "$PWD":/backup:ro alpine:3.22 sh -c \
  'find /data -mindepth 1 -maxdepth 1 ! -name huggingface -exec rm -rf {} + && tar xzf /backup/voicestudio-daten.tar.gz -C /data'
docker compose start
Wir haben vor dem Backup eine Markerdatei angelegt, das Volume komplett gelöscht und neu aufgebaut. Danach gab es nur noch die Demostimme. Nach dem Einspielen waren Marker, das geklonte Profil und beide Verlaufseinträge wieder da.
Verifizieren: curl -s -H "Authorization: Bearer $OMNIVOICE_API_KEY" http://127.0.0.1:3900/profiles listet Ihre Stimmen. Nach einer Wiederherstellung auf einen neuen Server meldet /setup/status zunächst "models_ready":false; laden Sie das Modell wie in Schritt 3 neu.
Schritt 8: Updates
Es gibt zwei Kanäle. :latest und :main sind laufende Vorschauversionen aus dem Hauptzweig, :stable zeigt auf das letzte Release, und Tags wie :0.5.6 bleiben fest. Für einen Server empfehlen wir den festen Versions-Tag, damit ein Neustart nicht unbemerkt eine Vorschau einspielt. Lesen Sie vor dem Wechsel die Release-Notes, sichern Sie wie in Schritt 7 und ändern Sie dann den Tag:
sed -i 's/omnivoice-studio:0.5.6/omnivoice-studio:NEUE-VERSION/' compose.yaml
docker compose pull
docker compose up -d
Der Update-Kanal in der Oberfläche unter Einstellungen gilt laut Dokumentation nur für die Desktop-App, nicht für das Docker-Image.
Verifizieren: curl -s http://127.0.0.1:3900/health zeigt die neue Versionsnummer, die Oberfläche unten rechts ebenfalls.
Typische Fehler
| Meldung | Ursache und Lösung |
|---|---|
required variable OMNIVOICE_API_KEY is missing a value | Kein Key in .env oder in der Shell. Key wie in Schritt 1 erzeugen. Mit der Upstream-Datei lautet der Zusatz export a long random OMNIVOICE_API_KEY before starting a Studio profile. |
no service selected | Die Upstream-Datei wurde ohne --profile cpu (oder gpu, rocm) gestartet. Profil angeben oder die schlanke Datei aus Schritt 1 nutzen. |
HTTP 401 {"detail":"API key required"} | Kein oder falscher Key im Header Authorization: Bearer. Ohne Key ist nur /health und die Anmeldeseite erreichbar. |
HTTP 429 Too many authentication attempts | Im Test sperrte VoiceStudio die Absenderadresse nach zehn falschen Anmeldeversuchen, Retry-After: 60. Eine Minute warten, Key prüfen. |
| Generierung dauert Minuten | Rechnet auf CPU. Unter Leistung und Gerät prüfen, ggf. GPU einbinden. Auf CPU gilt ein Zeitbudget von 600 Sekunden je Generierung (OMNIVOICE_CPU_GENERATE_TIMEOUT_S), lange Texte teilt VoiceStudio automatisch in Abschnitte. |
"models_ready":false nach Restore | Modell bewusst nicht gesichert. Erneut über /models/install laden. |
no matching manifest for linux/arm64/v8 | ARM-Host. Es gibt nur amd64-Images; auf einen x86-64-Server ausweichen. |
Rechtlicher Hinweis zum Stimmenklonen
Eine Stimme ist ein persönliches Merkmal. Nach DSGVO können Sprachaufnahmen personenbezogene Daten sein, und eine täuschend echte Nachahmung kann Persönlichkeitsrechte verletzen. Klonen Sie daher nur Ihre eigene Stimme oder Stimmen von Personen, die schriftlich eingewilligt haben, etwa einem Sprecher Ihres Unternehmens, und dokumentieren Sie den Zweck. Kennzeichnen Sie erzeugte Ansagen gegenüber Dritten als synthetisch. Das ist eine allgemeine Einordnung, keine Rechtsberatung; bei konkreten Projekten klären Sie die Lage mit Ihrem Datenschutzbeauftragten.
Eckdaten
| Version | 0.5.6, Lizenz AGPL-3.0 |
| Image | ghcr.io/debpalash/omnivoice-studio:0.5.6 (Mirror palashdeb/omnivoice-studio), nur amd64, 5,7 GB |
| Port | 3900 (Oberfläche und API), nur 127.0.0.1 |
| Volume | /app/omnivoice_data (Datenbank, Stimmen, Ausgaben, Modell-Cache) |
| Pflicht-Variable | OMNIVOICE_API_KEY |
| Pflichtmodell | k2-fsa/OmniVoice, 3,27 GB |
| RAM im Test | 1,9 GB Leerlauf, 6,5 GB Spitze (CPU) |
| Rechenzeit CPU | 220 bis 252 s für 7,5 s Audio |
Häufige Fragen
Ist VoiceStudio wirklich offline?
Nach dem Laden der Modelle läuft die Synthese lokal. Beim ersten Einsatz lädt VoiceStudio Modelle von Hugging Face, darunter auch das AudioSeal-Wasserzeichenmodell. Nutzungsstatistiken werden nur nach Zustimmung gesendet.
Wie gut ist die Qualität auf Deutsch?
Das Modell unterstützt laut Projekt über 600 Sprachen, Deutsch eingeschlossen. Die Qualität hängt stark vom Referenzclip ab: ruhige Umgebung, ein Sprecher, 5 bis 15 Sekunden.
Kann ich VoiceStudio aus eigenen Programmen ansprechen?
Ja. Neben der eigenen REST-API gibt es den OpenAI-kompatiblen Endpunkt /v1/audio/speech. Übergeben Sie den API-Key als Bearer-Token und nur über HTTPS.
Reicht ein kleiner VPS?
Für Tests ja, wenn er x86-64 ist und mindestens 8 GB RAM hat. Produktiv ist ein Rechner mit Grafikkarte die bessere Wahl, weil die CPU-Laufzeiten für längere Texte zu hoch sind.
Fazit
VoiceStudio 0.5.6 lässt sich mit einer kurzen Compose-Datei sauber betreiben: fester Tag, Pflicht-Key, Port nur auf Loopback, ein Volume für alles. Installation, Modell-Download, Stimmklon, Generierung, Backup und Restore liefen im Test ohne Eingriff. Die Schwachstelle ist die Rechenzeit ohne Grafikkarte. Wer nur gelegentlich kurze Ansagen braucht, kommt mit einem CPU-Server aus; für Hörbücher, Videos oder viele Nutzer gehört eine GPU dazu. Behandeln Sie den API-Key wie ein Administratorpasswort und setzen Sie Stimmklone nur mit Einwilligung ein.
Weiterführende Anleitungen und Quellen
- Whisper lokal per Docker: Audio und Video transkribieren
- Whisper lokal installieren: Offline-Spracherkennung mit Oberfläche
- Ollama und Open WebUI mit Docker: lokales LLM
- VoiceStudio auf GitHub
- VoiceStudio: Install with Docker (v0.5.6)
- VoiceStudio: Authenticating the local API
- VoiceStudio: Performance