RAGFlow mit Docker installieren: Enterprise-RAG-Engine für eigene Wissensdatenbanken
RAGFlow ist eine vollständige Open-Source-RAG-Plattform mit 82.000+ GitHub-Stars, die OCR, intelligentes Chunking und visuelle Agenten-Workflows vereint. Per Docker Compose läuft die Enterprise-Engine auf jedem Linux-Server – ohne Programmierkenntnisse, aber mit echter Datensouveränität.
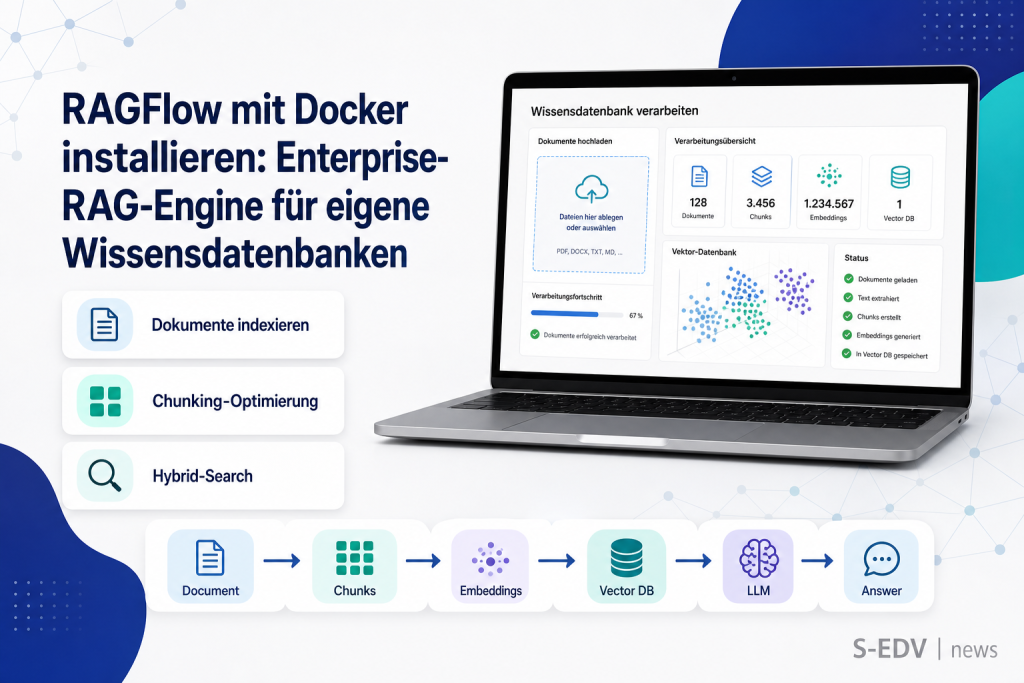
Wer eigene Dokumente datenschutzkonform mit einem KI-Sprachmodell durchsuchbar machen möchte, braucht mehr als ein einfaches Chat-Interface. RAGFlow von Infiniflow geht hier deutlich weiter: Die Plattform kombiniert Deep-Document-Understanding (PDF, Word, Excel, Bilder mit OCR), template-basiertes Chunking, Hybrid-Search über Elasticsearch und einen grafischen Agenten-Workflow-Editor zu einer vollständigen RAG-Pipeline. Das Ergebnis lässt sich ohne eine einzige Zeile Code per Docker Compose auf einem eigenen Linux-Server deployen – on-premise, DSGVO-konform, und mit einer Web-Oberfläche, die auch Nicht-Entwickler im Team nutzen können. Mit über 82.500 GitHub-Stars gehört RAGFlow zu den meistgenutzten Open-Source-RAG-Projekten überhaupt.
Voraussetzungen
- Betriebssystem: Linux x86_64 (AMD64) – empfohlen Ubuntu 22.04/24.04 LTS oder Debian 12. ARM64 (Apple Silicon, Raspberry Pi) wird offiziell nicht unterstützt.
- Docker Engine >= 24.0.0 und Docker Compose >= v2.26.1 – Installationsanleitung: Docker und Docker Compose auf Linux installieren.
- RAM: mindestens 16 GB, empfohlen 32 GB für den produktiven Betrieb.
- CPU: mindestens 4 Kerne, empfohlen 8+ Kerne.
- Speicher: mindestens 50 GB frei (SSD empfohlen) – das RAGFlow-Image allein belegt ca. 7 GB entpackt, Elasticsearch und MinIO wachsen je nach Datenmenge erheblich.
- Internet: stabiler Zugang für den initialen Download (~7 GB Gesamtgröße).
- LLM-API-Key: z. B. von OpenAI, DeepSeek oder ein lokaler Ollama-Server – wird erst nach der Installation benötigt.
- Optional: einen Reverse Proxy (z. B. Traefik oder Nginx Proxy Manager) für HTTPS und eine eigene Domain.
Schritt 1: Kernel-Parameter setzen (Linux)
Elasticsearch benötigt einen erhöhten Wert für virtuelle Speicherbereiche. Ohne diese Anpassung bricht der Container beim Start sofort ab.
# Sofort wirksam (bis zum nächsten Reboot):
sudo sysctl -w vm.max_map_count=262144

# Dauerhaft persistent machen:
echo 'vm.max_map_count=262144' | sudo tee -a /etc/sysctl.conf
Verifizieren: sysctl vm.max_map_count muss vm.max_map_count = 262144 zurückgeben. Auf Windows-Hosts mit Docker Desktop ist dieser Schritt nicht nötig – Docker Desktop setzt den Wert automatisch in der internen VM.
Schritt 2: Repo klonen und Projektordner vorbereiten
RAGFlow wird ausschließlich über das offizielle GitHub-Repository bezogen. Die compose-Konfiguration besteht aus zwei verknüpften Dateien (docker-compose.yml + docker-compose-base.yml), daher muss das vollständige Repo geklont werden – einzelne Dateien aus Drittquellen führen zu Konfigurationsdrift.
# Repo klonen (ca. 50 MB, ohne Images):
git clone https://github.com/infiniflow/ragflow.git

# In das Docker-Verzeichnis wechseln:
cd ragflow/docker

# .env-Vorlage kopieren:
cp .env .env.backup
Verifizieren: ls ragflow/docker/ zeigt docker-compose.yml, docker-compose-base.yml, .env und weitere Konfigurationsdateien. Fehlen diese, den Clone wiederholen.
Schritt 3: Umgebungsvariablen in der .env anpassen
Die .env steuert alle sicherheitsrelevanten Einstellungen. Alle Standard-Passwörter lauten infini_rag_flow – wer diese unverändert lässt, öffnet Elasticsearch, MySQL, MinIO und Redis für jeden im Netzwerk. Passwörter vor dem ersten Start ändern.
# --- RAGFlow Version (aktuell stabil: v0.26.0) ---
RAGFLOW_IMAGE=infiniflow/ragflow:v0.26.0

# --- Dokumenten-Engine (Standard: Elasticsearch) ---
DOC_ENGINE=elasticsearch
STACK_VERSION=8.11.3

# --- Recheneinheit: cpu | gpu ---
DEVICE=cpu

# --- Sichere Passwörter setzen (PFLICHT!) ---
ELASTIC_PASSWORD=MeinSicheresESPasswort2026!
MYSQL_PASSWORD=MeinSicheresMySQL2026!
MINIO_USER=ragflow_admin
MINIO_PASSWORD=MeinSicheresMinIO2026!
REDIS_PASSWORD=MeinSicheresRedis2026!

# --- Zeitzone (DACH) ---
TZ=Europe/Berlin

# --- Ports (Standardwerte beibehalten oder anpassen) ---
SVR_HTTP_PORT=80
ES_PORT=1200
MINIO_PORT=9000
MINIO_CONSOLE_PORT=9001

# --- RAM-Limit pro Container (Standard 8 GB) ---
# Bei Parsing-Abbrüchen auf 16 GB erhöhen:
MEM_LIMIT=8073741824

# --- Upload-Limit (Standard 1 GB) ---
MAX_CONTENT_LENGTH=1073741824

# --- Nutzerregistrierung (nach Admin-Setup auf 0 setzen) ---
REGISTER_ENABLED=1

# --- HuggingFace Mirror (bei eingeschränktem Internetzugang) ---
# HF_ENDPOINT=https://hf-mirror.com
Verifizieren: grep -E 'PASSWORD|MINIO_PASSWORD|REDIS' .env darf keinen Wert infini_rag_flow mehr anzeigen. Der Befehl sollte nur die selbst gesetzten Passwörter ausgeben.
Schritt 4: Eckdaten im Überblick
Zur Orientierung: Image, Ports, Volumes und wichtige Umgebungsvariablen in der Zusammenfassung.
| Parameter | Wert | Hinweis |
|---|---|---|
| Image | infiniflow/ragflow:v0.26.0 | Nur x86_64; GPU über DEVICE=gpu |
| Port 80 | Web-UI + nginx-Proxy | Hauptzugang Browser |
| Port 9380 | REST-API (direkt) | Ohne nginx-Proxy |
| Port 9382 | MCP-Protokoll | KI-Agenten-Integration |
| Port 1200 | Elasticsearch HTTP | Extern 1200 → intern 9200 |
| Port 9000/9001 | MinIO S3-API / Konsole | Objektspeicher |
| Volume mysql_data | /var/lib/mysql | Named volume, PFLICHT persistieren |
| Volume es_data | /usr/share/elasticsearch/data | Kann sehr groß werden |
| Volume minio_data | /data | Alle hochgeladenen Dokumente |
| MEM_LIMIT | 8073741824 (8 GB) | Bei Parsing-Abbrüchen erhöhen |
| DOC_ENGINE | elasticsearch (Standard) | Alternativ: infinity, opensearch |
Schritt 5: Stack starten
RAGFlow bringt alle abhängigen Dienste (MySQL, Elasticsearch, MinIO, Redis/Valkey) über die compose-Konfiguration direkt mit. Der erste Start dauert länger, weil alle Images heruntergeladen werden (~7 GB gesamt).
# Im Verzeichnis ragflow/docker/ ausführen:
docker compose up -d

# Echtzeit-Logs des RAGFlow-Kerns beobachten:
docker compose logs -f ragflow
RAGFlow wartet intern auf Elasticsearch und MySQL (Health-Checks). Die vollständige Initialisierung dauert typischerweise 2–5 Minuten. Der Stack ist betriebsbereit, wenn in den Logs server is running erscheint.
Verifizieren:
docker compose psErwartete Ausgabe – alle Container müssen im Status Up sein, Elasticsearch und MySQL zusätzlich (healthy):
NAME                IMAGE                           STATUS
ragflow-cpu         infiniflow/ragflow:v0.26.0      Up (healthy)
ragflow-es          elasticsearch:8.11.3            Up (healthy)
ragflow-mysql       mysql:8.0.39                    Up (healthy)
ragflow-minio       minio/minio:latest              Up
ragflow-redis       valkey/valkey:8                 Up
API-Erreichbarkeit prüfen:
curl -s http://localhost:9380/health
# Erwartete Ausgabe: {"code":0} oder {"status":"ok"}
Schritt 6: Erst-Einrichtung im Browser
RAGFlow hat keinen vordefinierten Admin-Account. Beim ersten Öffnen erscheint ein Registrierungsformular – der erste registrierte Nutzer wird automatisch Administrator.
- Browser öffnen:
http://<SERVER-IP>(Port 80 ist Standard) - Registrierungsformular ausfüllen: E-Mail, Passwort – dieser Account wird Admin
- Nach dem Login: Settings › Model Providers aufrufen
- LLM-Anbieter wählen (z. B. OpenAI, DeepSeek) und API-Key eingeben
- Für lokale Modelle (Ollama, LM Studio): Basis-URL
http://host.docker.internal:<PORT>eintragen - Nach der Einrichtung in der
.envREGISTER_ENABLED=0setzen und Stack neu starten
Verifizieren: Nach dem Login ist das RAGFlow-Dashboard sichtbar. Unter Settings › Model Providers sollte der konfigurierte Anbieter mit grünem Status erscheinen. Eine Test-Abfrage in einem leeren Workspace bestätigt die LLM-Verbindung.
Schritt 7: Wissensdatenbank anlegen und Dokumente hochladen
Das Herzstück von RAGFlow sind die Knowledge Bases. Jede Wissensdatenbank hat eine eigene Chunking-Strategie, die auf den Dokumenttyp abgestimmt werden kann.
- Im Dashboard Knowledge Base aufrufen und „Create Knowledge Base" klicken
- Name, Beschreibung und Chunk Method wählen (z. B. „General", „Q&A", „Paper", „Manual" je nach Dokumenttyp)
- Dokumente hochladen (PDF, Word, Excel, PowerPoint, TXT, HTML, Markdown, Bilder mit OCR) – bis zu 1 GB pro Datei, 32 Dateien pro Batch
- Parsing starten – RAGFlow verarbeitet die Dokumente mit Deep-Document-Understanding (OCR, Tabellen- und Bildanalyse)
- Nach Abschluss des Parsings steht die Wissensdatenbank für Chat und Agenten-Workflows bereit
Verifizieren: Im Dokument-Status wechselt die Anzeige von „Parsing" auf „Done". In den Logs ist kein Fehler zu sehen: docker compose logs ragflow | grep -i error sollte leer bleiben. Eine Testfrage im Chat über die Wissensdatenbank liefert eine Antwort mit Quellangaben.
Schritt 8: Updates und Backup
RAGFlow entwickelt sich schnell. Vor jedem Update eine Datensicherung anlegen – alle kritischen Daten liegen in den Named Volumes.
# Backup der Named Volumes (vor Update empfohlen):
docker run --rm \
  -v ragflow_mysql_data:/source:ro \
  -v $(pwd)/backup:/backup \
  alpine tar czf /backup/mysql_data_$(date +%Y%m%d).tar.gz -C /source .

# Update: neue Image-Version in .env setzen, dann:
docker compose pull
docker compose up -d

# Logs nach Update prüfen:
docker compose logs -f ragflow
Eine systematische Backup-Strategie für Docker-Volumes: Docker Compose absichern: Secrets, Healthchecks und Non-Root.
Verifizieren: Nach dem Update docker compose ps prüfen – alle Container im Status Up (healthy). Die Web-Oberfläche unter Port 80 muss erreichbar sein und die neue Version unter Settings › System anzeigen.
Troubleshooting / Typische Fehler
- „max virtual memory areas vm.max_map_count [65530] is too low" (Elasticsearch startet nicht):
vm.max_map_countnicht gesetzt oder Reboot hat ihn zurückgesetzt. Fix:sudo sysctl -w vm.max_map_count=262144– dauerhaft in/etc/sysctl.confeintragen. - Browser zeigt „network abnormal" direkt nach dem Start: RAGFlow ist noch nicht vollständig initialisiert. Fix:
docker compose logs -f ragflowbeobachten, bisserver is runningerscheint – erst dann den Browser öffnen. - Parsing bleibt bei ~90% stehen oder bricht ab:
MEM_LIMITin der.envist zu niedrig. Fix: auf16073741824(16 GB) erhöhen, danndocker compose stop && docker compose up -d. - Elasticsearch-Container Status „unhealthy" trotz laufendem Container: Häufig falsches
ELASTIC_PASSWORDoder fehlendesvm.max_map_count. Diagnose:docker compose logs ragflow-es. - „exec format error" beim Starten (ARM64/Apple Silicon): Es gibt keine offiziellen ARM64-Images. Das Image muss aus dem Quellcode selbst gebaut werden (
ragflow/docs/dev/build_docker_image). - „address already in use" für Port 80: Ein anderer Webserver belegt Port 80. Fix:
SVR_HTTP_PORT=8080in der.envsetzen unddocker compose up -dneu starten. - HuggingFace-Embedding-Modelle werden nicht geladen: Eingeschränkter Internetzugang. Fix:
HF_ENDPOINT=https://hf-mirror.comin der.envsetzen, Dienste neu starten. - nginx-Fehler „ragflow.conf.python not found": Einzelne Dateien wurden kopiert statt das komplette Repo zu klonen. Fix: vollständigen
git clonedurchführen. - GPU wird nicht erkannt (DEVICE=gpu):
nvidia-container-toolkitmuss auf dem Host installiert sein und Docker für GPU-Zugriff konfiguriert werden:nvidia-ctk runtime configure --runtime=docker. Das GPU-compose-File wird vom RAGFlow-Team als „use at your own risk" eingestuft.
Häufige Fragen
Wie lautet das Standard-Login nach der Installation?
RAGFlow hat keinen vordefinierten Admin-Account. Beim ersten Aufruf von http://<HOST-IP> erscheint ein Registrierungsformular. Der erste registrierte Nutzer wird automatisch Administrator. Danach empfiehlt sich REGISTER_ENABLED=0 in der .env, um weitere Selbst-Registrierungen zu verhindern.
Wie ändere ich den Web-Port von 80 auf einen anderen Port?
In docker/. env den Wert SVR_HTTP_PORT=8080 (oder einen anderen freien Port) setzen. Anschließend docker compose stop && docker compose up -d. Der Zugriff erfolgt dann über http://<HOST-IP>:8080.
Wie verbinde ich RAGFlow mit einem lokalen Ollama-Modell?
Im Web-UI unter Settings › Model Providers den Anbieter „Ollama" auswählen und die Basis-URL http://host.docker.internal:11434 eintragen (der spezielle DNS-Name host.docker.internal zeigt auf den Docker-Host). Für LM Studio oder andere lokale Server die entsprechende Port-Nummer anpassen. Eine ausführliche Anleitung zu lokalen LLM-Modellen: Ollama und Open WebUI mit Docker – eigenes lokales KI-Sprachmodell ohne Cloud.
Kann ich die Dokumenten-Engine von Elasticsearch auf Infinity wechseln?
Ja: DOC_ENGINE=infinity in der .env setzen, dann docker compose down && docker compose up -d. Achtung: Bestehende Elasticsearch-Dokumente werden dabei nicht migriert. Infinity ist ressourcenschonender, ein offizieller ARM64-Support fehlt aber auch dort.
Wie groß wird die Installation ungefähr?
Das RAGFlow-Image belegt ca. 7 GB entpackt. Elasticsearch-Daten und MinIO-Objekte wachsen je nach Dokumentenmenge. Für eine initiale Installation ohne umfangreiche Dokumente sollten 50 GB freier SSD-Speicher als Minimum eingeplant werden.
Welche Dokumentformate werden unterstützt?
PDF, Word (.docx), Excel (.xlsx), PowerPoint (.pptx), TXT, HTML, Markdown, sowie Bilder mit OCR-Analyse. RAGFlow analysiert dabei Tabellen und Layoutstrukturen mit Deep-Document-Understanding – besonders bei komplexen PDFs ein deutlicher Vorteil gegenüber einfachen Text-Splittern.
Was ist der MCP-Endpunkt auf Port 9382?
RAGFlow implementiert das Model Context Protocol (MCP), über das andere KI-Agenten und Anwendungen die RAGFlow-Wissensdatenbanken als standardisiertes Tool einbinden können. Port 9382 sollte nur intern oder über einen gesicherten Tunnel erreichbar sein.
Fazit
RAGFlow ist derzeit eine der vollständigsten selbstgehosteten RAG-Plattformen: Der visuelle Pipeline-Editor, die MCP-Unterstützung, das Deep-Document-Understanding und die breite LLM-Kompatibilität machen es zu einer ernsthaften Enterprise-Alternative zu proprietären Lösungen. Die Docker-Compose-Installation ist mit dem offiziellen Repo unkompliziert – solange die Voraussetzungen stimmen: x86_64-Linux, mindestens 16 GB RAM, vm.max_map_count korrekt gesetzt und eigene Passwörter in der .env. Der erhöhte Ressourcenverbrauch durch Elasticsearch, MySQL und MinIO ist der Preis für die volle Funktionalität. Wer ein schlankes RAG-System ohne eigenen Vektor-Index sucht, findet in AnythingLLM eine leichtgewichtigere Alternative. Für tiefergehendes Verständnis der RAG-Grundlagen empfiehlt sich ein Blick in RAG produktiv betreiben: Chunking, Hybrid-Search, Reranking und Antwortqualität messen.
Weiterführende Anleitungen und Quellen
- Docker und Docker Compose auf Linux installieren (Ubuntu/Debian): die Self-Hosting-Grundlage
- Ollama und Open WebUI mit Docker: eigenes lokales KI-Sprachmodell ohne Cloud betreiben
- AnythingLLM installieren (Docker): Lokale KI-Zentrale mit RAG-Workspaces und Ollama
- RAG produktiv betreiben: Chunking, Hybrid-Search, Reranking und Antwortqualität messen
- Docker Compose absichern: Secrets, Healthchecks, Non-Root und Read-Only für den Produktivbetrieb
- Traefik als Docker-Reverse-Proxy mit automatischem HTTPS einrichten
Offizielle Quellen: RAGFlow GitHub Repository (infiniflow/ragflow) – README, docker-compose.yml, .env-Referenz. RAGFlow Offizielle Dokumentation – Quickstart, Konfiguration, FAQ. RAGFlow auf Docker Hub – Image-Tags und Versionsübersicht.