Bremst ein Snapshot die Platte? Messung mit fio auf einem netcup-VPS
fio-Messung auf einem netcup-VPS: Direkt nach einem Snapshot fällt das zufällige Schreiben um 71 bis 87 %, ab der zweiten Runde liegt die Platte wieder im Normalbereich. Ausfall beim Anlegen 35 bis 51 Sekunden, Löschen in Sekunden ohne Neustart.
Werbung Mit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Vor einem Update schnell einen Snapshot ziehen, das gehört bei vielen Admins zur Routine. Doch kostet ein Snapshot Leistung, solange er existiert? Diese Anleitung misst es mit fio auf einem netcup VPS 500 G12.5 mit 2 Kernen und 4 GB RAM: erst ohne Snapshot, dann mit einem und mit drei Snapshots, nach dem Löschen und zur Kontrolle nach einem Neustart ohne Snapshot. Je Zustand laufen vier Runden mit fünf Plattentests. Das Ergebnis ist eindeutiger als erwartet, und ein Nebenbefund bleibt rätselhaft.
Dies ist Messung 3 der Reihe „Grenzlast“. Die Reihe misst, wo ein kleiner VPS an seine Grenzen kommt. Der Server ist derselbe wie in der Reihe „Server im Netz“, auf ihm laufen nebenher 18 Container mit Mail, Matrix, Forgejo und weiteren Diensten. Die Messwerte stammen also aus dem echten Betrieb.
Voraussetzungen
- Ein netcup-Server mit Zugang zum Server Control Panel und einem Token für die SCP-REST-API. Wie Sie den Token holen und Snapshots per Skript anlegen, zeigt netcup-Snapshots per SCP-REST-API.
- Rund 5 GiB freier Platz auf dem Server für die Testdatei.
- fio und jq auf dem Server, unter Ubuntu mit
apt install fio jq. - Ein Zeitfenster, in dem der Server mehrmals für bis zu einer Minute ausfallen darf.
| Eckdaten | Wert |
|---|---|
| Server | netcup VPS 500 G12.5, 2 Kerne, 4 GB RAM, 64 GiB virtio, Ubuntu 24.04, ext4, UEFI aktiv |
| Werkzeug | fio 3.36, direct I/O, libaio |
| Testdatei | 4 GiB, vor der ersten Messung komplett geschrieben |
| Tests je Runde | je 30 Sekunden: 4k zufällig schreiben und lesen (Tiefe 32), 4k zufällig schreiben (Tiefe 1), 1 MB sequenziell schreiben und lesen (Tiefe 8) |
| Runden | 4 je Zustand, 10 Sekunden Pause |
Schritt 1: Testdatei und Messskript
fio braucht eine Datei, die vor der ersten Messung vollständig geschrieben ist. Sonst trifft der erste Durchlauf auf reservierte, aber noch nie beschriebene Bereiche, und die Werte sind verfälscht. Mit --direct=1 umgeht fio den Seitencache von Linux, die Werte zeigen also die virtuelle Platte und nicht den Arbeitsspeicher.
mkdir -p /root/fio && cd /root/fio
fio --name=fuellen --filename=test.dat --size=4G --rw=write --bs=1M \
  --direct=1 --ioengine=libaio --iodepth=8 --output-format=terse >/dev/null
Das Messskript fährt fünf Tests hintereinander und speichert jeden als JSON. Beim zufälligen Schreiben protokolliert es zusätzlich die Schreibvorgänge pro Sekunde, das wird gleich wichtig.
#!/bin/bash
# mess.sh LABEL: eine Runde mit fünf Tests à 30 Sekunden
cd /root/fio; L=$1
G="--filename=test.dat --size=4G --direct=1 --ioengine=libaio --time_based --runtime=30 --output-format=json"
fio --name=rw4k --rw=randwrite --bs=4k --iodepth=32 $G --write_iops_log=log-$L-rw4k --log_avg_msec=1000 > $L-rw4k.json
fio --name=rr4k --rw=randread  --bs=4k --iodepth=32 $G > $L-rr4k.json
fio --name=lat4k --rw=randwrite --bs=4k --iodepth=1 $G > $L-lat4k.json
fio --name=sw1m --rw=write --bs=1M --iodepth=8 $G > $L-sw1m.json
fio --name=sr1m --rw=read  --bs=1M --iodepth=8 $G > $L-sr1m.json
Speichern Sie das Skript als mess.sh und machen Sie es mit chmod +x mess.sh ausführbar.
ls -l test.dat zeigt 4294967296 Bytes, nach einer Runde liegen fünf JSON-Dateien und eine Datei log-…-rw4k_iops.1.log im Ordner.
Schritt 2: Den Ausgangswert messen
Vier Runden ohne Snapshot zeigen, wie stark die Werte von sich aus schwanken. Auf einem VPS teilen sich viele Kunden den Speicher, das ist die naheliegende Erklärung für die Streuung. Beim zufälligen Schreiben lagen die Runden zwischen 22.900 und 49.674 Vorgängen pro Sekunde, im Median bei 29.094. Ein einzelner Messwert sagt deshalb wenig. Erst mehrere Runden zeigen, ob ein Unterschied echt ist.
for i in 1 2 3 4; do ./mess.sh basis$i; sleep 10; done
jq '.jobs[0].write.iops' basis*-rw4k.json
Der jq-Befehl gibt vier Werte aus, beim zufälligen Lesen zeigt .jobs[0].read.iops in den rr4k-Dateien Werte um 50.000.
Schritt 3: Den Snapshot anlegen
Ist im Server Control Panel UEFI aktiv, lehnt netcup Snapshots im laufenden Betrieb ab. Die API antwortet mit 400 und dem Text Online snapshot creation is not possible if UEFI is activated. Der Snapshot entsteht deshalb in drei Schritten: Server aus, Snapshot, Server an. Jeder Schritt liefert einen Task, dessen Status das Skript abfragt, bis er FINISHED meldet. Brechen Sie auch bei ERROR, CANCELED oder ROLLBACK ab. PATCH-Aufrufe erwarten den Header Content-Type: application/merge-patch+json, vor dem Abschalten schreibt sync offene Daten auf die Platte.
PATCH /api/v1/servers/{id}             {"state": "OFF"}
POST  /api/v1/servers/{id}/snapshots   {"name": "grenzlast-1", "diskName": "vda", "onlineSnapshot": false}
PATCH /api/v1/servers/{id}             {"state": "ON"}
GET   /api/v1/tasks/{uuid}             bis "state": "FINISHED"
Der Snapshot selbst war jedes Mal in weniger als fünf Sekunden fertig, laut Zeitstempel der API nach etwa einer Sekunde. Das Skript fragt den Task nur alle fünf Sekunden ab. Länger dauern Abschalten und Hochfahren: Vom Befehl zum Abschalten bis SSH wieder antwortete, vergingen beim ersten Snapshot 37 Sekunden, beim zweiten 35, beim dritten 51. Beim dritten brauchte das Abschalten allein 26 Sekunden. Weil auch die Erreichbarkeit nur alle fünf Sekunden geprüft wird, sind die Werte auf etwa fünf Sekunden genau. Bis alle Container der anderen Dienste liefen, dauerte es etwas länger, die Messung wartet deshalb 45 Sekunden.
sleep 45
for i in 1 2 3 4; do ./mess.sh snap1-$i; sleep 10; done
Die Antworten der API enthalten im Feld executingUser Name, Mailadresse und Kundennummer des Kontos. Wer Protokolle der Aufrufe aufhebt oder weitergibt, sollte das Feld vorher entfernen.
GET /api/v1/servers/{id}/snapshots listet den Snapshot mit "online": false.
Schritt 4: Die erste Schreibrunde danach
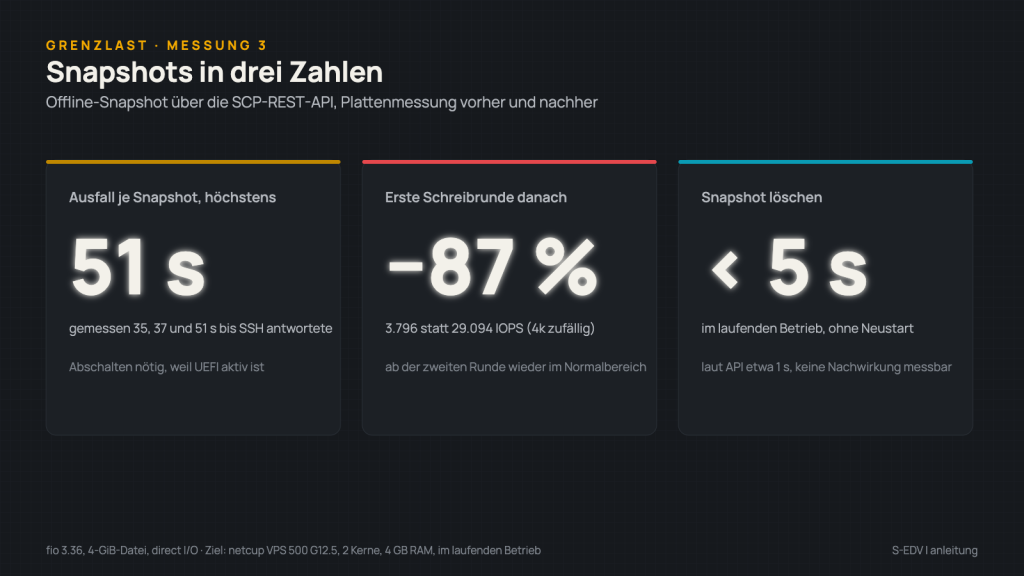
Direkt nach dem ersten Snapshot schaffte die Platte beim zufälligen Schreiben nur noch 3.796 Vorgänge pro Sekunde, 87 % weniger als der Median ohne Snapshot. Auch das zufällige Lesen direkt danach lag mit 3.867 statt rund 54.000 tief, und das Schreiben mit Tiefe 1 erreichte 2.677 statt rund 6.000 Vorgänge pro Sekunde.
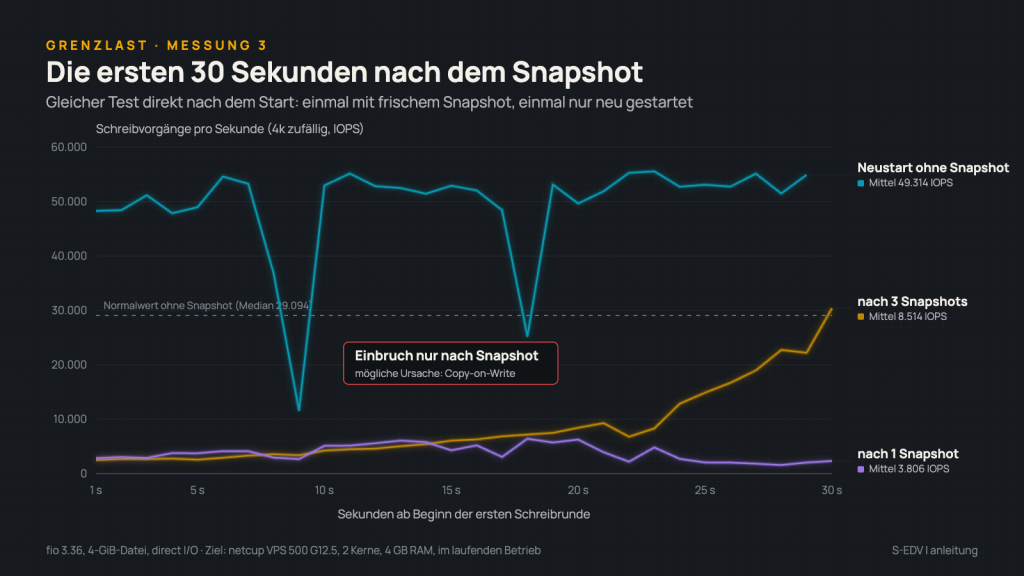
Der Sekundenverlauf ist nicht einheitlich. Nach drei Snapshots startete die Runde bei 2.500 Vorgängen pro Sekunde und kletterte bis zum Ende auf 30.000. Nach dem ersten Snapshot blieb sie die ganzen 30 Sekunden unter 6.500, und auch das zufällige Lesen direkt danach war eingebrochen. Der Anstieg passt zu einem Copy-on-Write-Verfahren, das beim ersten Schreiben in einen Bereich nach dem Snapshot zusätzliche Arbeit hat. Den Leseeinbruch erklärt das nicht. Wie netcup Snapshots intern umsetzt, ist nicht dokumentiert, beides sind Vermutungen aus dem Verlauf.
cut -d, -f2 log-snap1-1-rw4k_iops.1.log listet die Werte je Sekunde, nach einem frischen Snapshot liegen sie zu Beginn weit unter dem Ausgangswert.
Schritt 5: Nur die erste Runde bricht ein
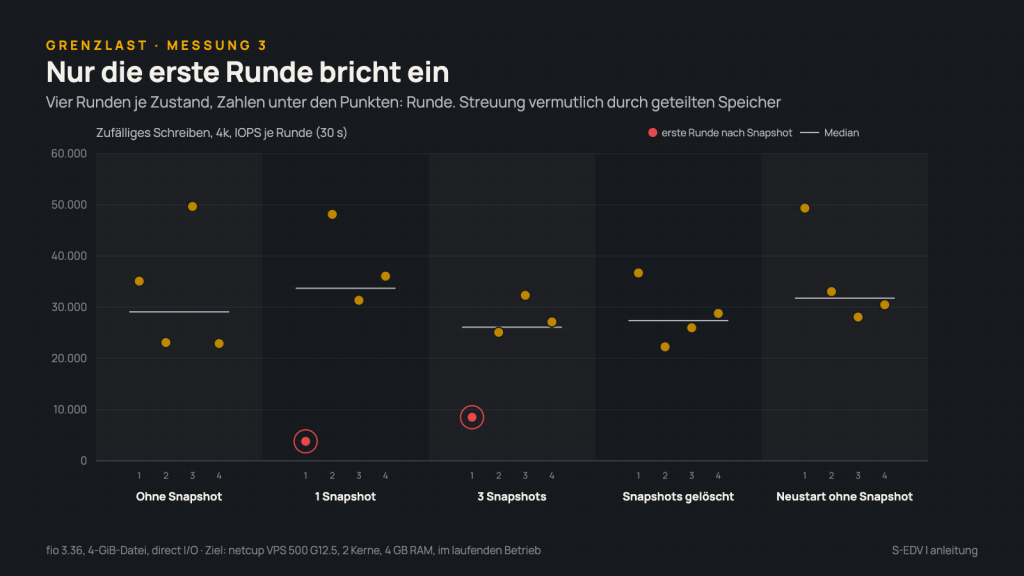
Ab der zweiten Runde lag das zufällige Schreiben wieder im normalen Bereich, die Runden 2 bis 4 im Median bei 36.061 mit einem und bei 27.123 mit drei Snapshots. Beide Werte liegen innerhalb der Streuung, die schon ohne Snapshot auftrat. Dass der Einbruch nach einer Runde vorbei war, liegt auch am Testaufbau: Der sequenzielle Schreibtest am Ende jeder Runde hat die 4-GiB-Datei mehrfach überschrieben. Mehrere Snapshots machten die Platte also nicht dauerhaft langsamer. Mit drei Snapshots war der Einbruch in der ersten Runde mit 8.509 Vorgängen pro Sekunde, 71 % unter dem Median, kleiner als beim ersten Snapshot, das zufällige Lesen blieb diesmal normal.
Für die Praxis heißt das: Direkt nach einem Snapshot schreibt der Server spürbar langsamer, bis die Daten, die er ändert, einmal neu geschrieben sind. Für ein normales Update dürfte das kaum auffallen. Eine Datenbank, die direkt nach dem Snapshot unter Volllast viele Blöcke ändert, würde es vermutlich spüren.
jq '.jobs[0].write.iops' snap1-*-rw4k.json zeigt einen niedrigen ersten und drei normale Werte.
Schritt 6: Löschen und Gegenprobe
Gelöscht werden Snapshots im laufenden Betrieb, ohne Neustart. Jeder Löschauftrag war nach wenigen Sekunden fertig, laut Zeitstempel der API etwa eine Sekunde nach dem Aufruf.
DELETE /api/v1/servers/{id}/snapshots/grenzlast-1
GET    /api/v1/servers/{id}/snapshots          ergibt []
Direkt danach lief die Platte normal, die erste Runde lag bei 36.689 Vorgängen pro Sekunde. Bleibt eine Frage: Kommt der Einbruch wirklich vom Snapshot oder nur vom Neustart, nach dem Zwischenspeicher auf dem Wirt leer sein könnten? Die Gegenprobe gibt eine klare Antwort. Ein Neustart über dieselbe API, diesmal ohne Snapshot, kostete 30 Sekunden Ausfall. Die erste Runde danach erreichte 49.352 Vorgänge pro Sekunde, so viel wie die beste Runde ohne Snapshot. Ein Neustart allein bremste hier also nicht.
Die Snapshot-Liste ist leer, und die erste Runde nach dem Kontroll-Neustart liegt im Bereich der Ausgangswerte.
Schritt 7: Große Dateien, ein offener Befund
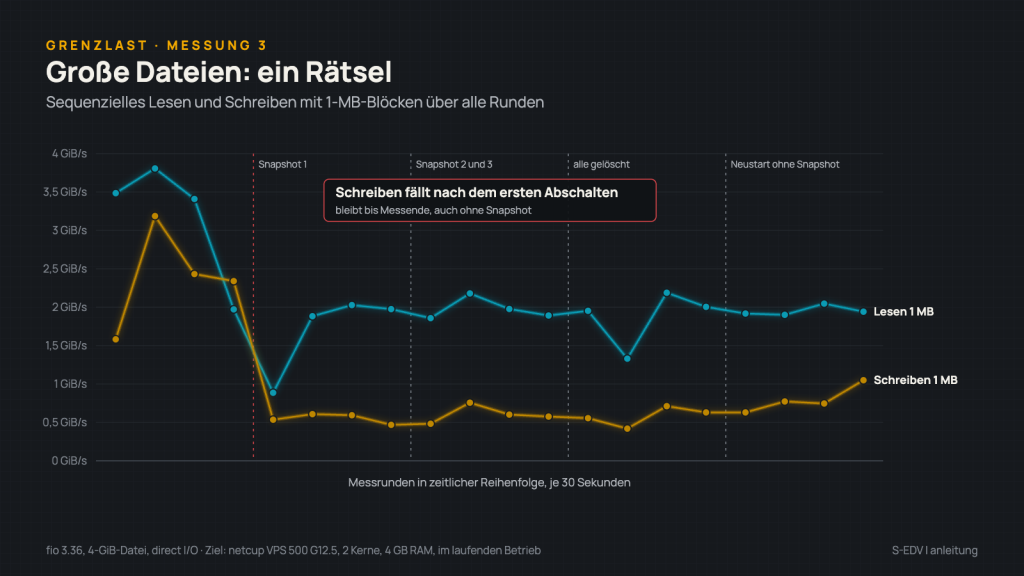
Beim sequenziellen Schreiben mit 1-MB-Blöcken zeigte sich etwas anderes. Vor dem ersten Abschalten lag es bei 1,6 bis 3,2 GiB/s. Ab dem ersten Snapshot fiel es auf 0,4 bis 1,0 GiB/s und blieb dort bis zum Ende der Messung, auch nach dem Löschen und im Kontrolllauf ohne Snapshot. Ein vorhandener Snapshot ist also nicht die Ursache. Ob das erste Abschalten, der erste Snapshot oder nur die Uhrzeit den Wechsel auslöste, lässt sich nicht trennen. Das sequenzielle Lesen sank schon in der letzten Runde vor dem ersten Abschalten von 3,4 bis 3,8 auf rund 2 GiB/s und blieb dann auf diesem Niveau.
Woran es liegt, lässt sich von innen nicht klären. Möglich sind Zwischenspeicher auf dem Wirt, die nach dem Abschalten anders arbeiten, oder mehr Betrieb der Nachbarn am späten Abend. Für die Frage, ob ein vorhandener Snapshot bremst, spielt es keine Rolle, weil der Wert in allen Zuständen nach dem ersten Abschalten gleich niedrig blieb. Wer große Dateien schreibt, etwa Backups, sollte aber wissen, dass sich der Durchsatz eines VPS ohne erkennbaren Anlass um den Faktor 4 ändern kann.
jq '.jobs[0].write.bw' *-sw1m.json zeigt die Werte in KiB/s, geteilt durch 1024 ergibt das MiB/s.
Troubleshooting
| Symptom | Ursache und Lösung |
|---|---|
400 mit Online snapshot creation is not possible if UEFI is activated. | Bei aktivem UEFI nur offline: Server per API abschalten, Snapshot mit "onlineSnapshot": false, Server einschalten. |
| Werte unrealistisch hoch, beim Lesen weit über der Plattenleistung | fio lief ohne --direct=1 und hat den Seitencache gemessen. |
| Erste Schreibrunde ohne Snapshot auffällig langsam | Die Testdatei war noch nicht vollständig geschrieben. Erst komplett füllen, dann messen. |
| PATCH an die SCP-API wird abgelehnt | Laut OpenAPI-Beschreibung erwartet die API dort Content-Type: application/merge-patch+json, nicht application/json. |
| Werte schwanken von Runde zu Runde um den Faktor 2 | Vermutlich geteilter Speicher auf dem Wirt. Mehrere Runden je Zustand messen und den Median vergleichen. |
| Mailadresse und Kundennummer im Protokoll | Die SCP-API liefert sie im Feld executingUser. Vor dem Speichern herausfiltern. |
Häufige Fragen
Muss ich Snapshots nach dem Update schnell wieder löschen?
Aus Leistungssicht nach dieser Messung nicht. Mit drei Snapshots lag die Platte nach der ersten Runde im Normalbereich. Gelöscht wurde in wenigen Sekunden ohne Ausfall. Ob Snapshots auf Dauer Speicherplatz oder Kontingent kosten, war nicht Teil dieser Messung.
Wie lange dauert der Einbruch nach einem Snapshot?
Im Test war der Einbruch nach der ersten Runde vorbei. In dieser Runde hat der sequenzielle Schreibtest die ganze 4-GiB-Datei mehrfach überschrieben. Auf einem echten Server hängt die Dauer davon ab, wie viele Daten er nach dem Snapshot ändert. Eine feste Zeitangabe lässt sich aus dieser Messung nicht ableiten.
Hat die Steal-Time die Messung verfälscht?
Die Steal-Time wurde nicht mitgemessen. Sie kann bei vielen Plattenzugriffen mitbremsen, erklärt aber nicht den Einbruch nur nach dem Snapshot, denn der Kontroll-Neustart zeigte ihn nicht. Die Streuung zwischen den Runden fängt die Anleitung mit Medianen aus vier Runden ab. Die CPU-Seite zeigt Steal-Time messen.
Fazit
Ein Snapshot bremst den kleinen netcup-VPS nur kurz: Die erste Schreibrunde danach fiel um 87 %, danach lief die Platte normal, auch mit drei Snapshots. Teurer ist der Ausfall beim Anlegen, weil netcup bei aktivem UEFI abschalten muss, hier 35 bis 51 Sekunden bis SSH, bis alle Container liefen etwas länger. Löschen geht schnell und ohne Nachwirkung. Wer vor einem Update einen Snapshot zieht, verliert also vor allem diese knappe Minute, nicht dauerhaft Leistung. Offen bleibt, warum das sequenzielle Schreiben nach dem ersten Abschalten auf ein Viertel fiel. Messung 2 der Reihe soll klären, wie viele Dienste in 4 GB RAM passen.