Graphify 0.9 mit Docker: Code und Dokumentation als lokaler Wissensgraph
Graphify 0.9.93 macht aus Code und Dokumentation einen abfragbaren Wissensgraphen. So betreiben Sie es per Docker Compose mit lokalem Sprachmodell über llama.cpp, Grafik im Browser, MCP-Server mit Schlüssel, Backup, Wiederherstellung und Update.
Geprüft am 22.10.2026 · für Graphify 0.9.93
Mit KI erstellt – redaktionelle Prüfung ausstehend
WerbelinksMit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Wer einem KI-Assistenten Fragen zu einem Projekt stellt, lässt ihn meist Datei für Datei lesen. Graphify macht daraus einen Wissensgraphen: Funktionen, Klassen und Inhalte aus Dokumenten werden zu Knoten, Aufrufe, Importe und Verweise zu Kanten, die Menschen und Agenten gezielt abfragen. Das Projekt von Graphify Labs steht unter Apache-2.0-Lizenz und hat rund 132.000 Sterne auf GitHub (Stand 22. Oktober 2026). Diese Anleitung betreibt Version 0.9.93 mit Docker Compose und einem lokalen Sprachmodell über llama.cpp, Code und Dokumente verlassen das eigene Netz nicht. Der Preis dafür ist Zeit: Ohne Grafikkarte brauchte der erste Graph aus einem Python-Paket mit fünf Dateien und zwei Dokumenten im Test 172 Sekunden.
Voraussetzungen
- Linux-Server oder VM mit Docker Engine und Docker Compose Plugin, getestet mit Docker 29.8.2 und Compose v5.5.1 unter Debian 12. Die Grundinstallation zeigt die Anleitung Docker Compose unter Linux.
- Die Werkzeuge curl, jq und openssl, unter Debian mit
sudo apt install curl jq openssl. - Eine x86-64-CPU mit möglichst vielen Kernen, getestet mit einem Intel Core i7-12700T (14 Kerne im Testsystem) ohne Grafikkarte.
- Mindestens 8 GB RAM. Im Test belegte llama.cpp direkt nach dem ersten Graphen 5,3 GiB, im Leerlauf 2,3 GiB. MCP-Server und nginx brauchten zusammen unter 80 MiB.
- Mindestens 10 GB freier Speicher: Images rund 1,9 GB (llama.cpp 1,22 GB, Graphify 540 MB, nginx 95 MB), Modellordner 4,2 GiB, beim Update zusätzlich das alte Image.
- Für den Zugriff von anderen Rechnern ein Reverse Proxy mit HTTPS und Anmeldung, zum Beispiel Caddy, oder ein SSH-Tunnel.
| Eckdaten | Wert |
|---|---|
| Paket | graphifyy==0.9.93 (PyPI, mit zwei y), eigenes Image auf python:3.12.15-slim-bookworm |
| Sprachmodell | ghcr.io/ggml-org/llama.cpp:server-b11804 mit Gemma 4 E2B (Q4_K_M) |
| Ports | 8765/tcp (MCP), 8766/tcp (Grafik im Browser), beide nur 127.0.0.1 |
| Daten | ./corpus (Quellen, nur lesend), ./out/graphify-out (Graph, Cache) |
Schritt 1: Projektordner, Dockerfile und compose.yaml anlegen
Ein fertiges Container-Image nennt die Dokumentation nicht, das Dockerfile im Repository baut aus dem Quellcode. Einfacher ist ein kleines Image, das die feste Version von PyPI installiert. Legen Sie den Projektordner an. Der Ausgabeordner gehört UID 1000, dem Benutzer im Container:
mkdir -p ~/graphify/{corpus,out,backups,data/models} && cd ~/graphify
sudo chown 1000:1000 out
cat > .env <<EOF
GRAPHIFY_VERSION=0.9.93
GRAPHIFY_API_KEY=$(openssl rand -hex 32)
EOF
chmod 600 .env
Daneben kommt das Dockerfile:
FROM python:3.12.15-slim-bookworm
ARG GRAPHIFY_VERSION
RUN pip install --no-cache-dir "graphifyy[mcp,openai,pdf]==${GRAPHIFY_VERSION}" \
 && useradd --create-home --uid 1000 graphify
USER graphify
WORKDIR /work/out
ENTRYPOINT ["graphify"]
Die Extras bringen den MCP-Server, den Client für OpenAI-kompatible Schnittstellen und das Lesen von PDFs mit. Dann die compose.yaml:
services:
  llama:
    image: ghcr.io/ggml-org/llama.cpp:server-b11804
    restart: unless-stopped
    environment:
      LLAMA_ARG_HOST: 0.0.0.0
      LLAMA_ARG_PORT: "8080"
      LLAMA_ARG_HF_REPO: bartowski/google_gemma-4-E2B-it-GGUF
      LLAMA_ARG_HF_FILE: google_gemma-4-E2B-it-Q4_K_M.gguf
      LLAMA_ARG_CTX_SIZE: "16384"
      LLAMA_ARG_N_PARALLEL: "2"
    volumes:
      - ./data/models:/root/.cache/huggingface
    healthcheck:
      test: ["CMD-SHELL", "curl -fsS http://localhost:8080/health || exit 1"]
      interval: 10s
      timeout: 5s
      retries: 90
      start_period: 30s

  graphify:
    image: local/graphify:${GRAPHIFY_VERSION:?GRAPHIFY_VERSION fehlt in .env}
    profiles: ["cli"]
    depends_on:
      llama:
        condition: service_healthy
    environment:
      OPENAI_BASE_URL: http://llama:8080/v1
      OPENAI_API_KEY: not-needed
      OPENAI_MODEL: gemma-4-e2b-it
      GRAPHIFY_MAX_OUTPUT_TOKENS: "4096"
      GRAPHIFY_API_TIMEOUT: "900"
    volumes:
      - ./corpus:/work/corpus:ro
      - ./out:/work/out

  mcp:
    build:
      context: .
      args:
        GRAPHIFY_VERSION: ${GRAPHIFY_VERSION}
    image: local/graphify:${GRAPHIFY_VERSION}
    restart: unless-stopped
    entrypoint: ["graphify-mcp"]
    command: ["/work/out/graphify-out/graph.json", "--transport", "http", "--host", "0.0.0.0", "--port", "8080"]
    environment:
      GRAPHIFY_API_KEY: ${GRAPHIFY_API_KEY:?GRAPHIFY_API_KEY fehlt in .env}
    ports:
      - "127.0.0.1:8765:8080"
    volumes:
      - ./out:/work/out:ro

  web:
    image: nginx:1.30.6-alpine
    restart: unless-stopped
    ports:
      - "127.0.0.1:8766:80"
    volumes:
      - ./out/graphify-out:/srv:ro
    configs:
      - source: web_conf
        target: /etc/nginx/conf.d/default.conf

configs:
  web_conf:
    content: |
      server {
        listen 80;
        root /srv;
        absolute_redirect off;
        location = / { return 302 /graph.html; }
        location ~ ^/(graph|callflow)\.html$ { }
        location / { return 404; }
      }
Der Dienst graphify ist das Kommandozeilenwerkzeug und läuft nur auf Abruf mit docker compose run (Profil cli). Das Backend openai erreicht laut Hilfe auch selbst betriebene Server wie llama.cpp. llama.cpp teilt den Kontext auf die Slots auf, hier 8.192 Token je Anfrage. Die Optionen --token-budget 2000 (Eingabe je Abschnitt) und GRAPHIFY_MAX_OUTPUT_TOKENS (Antwort, ab Werk 16.384) halten jede Anfrage darunter. Der MCP-Server liest den Graphen nur, nginx liefert ausschließlich die beiden HTML-Ansichten aus, nicht den Cache oder graph.json. Weitere Härtung beschreibt Docker Compose absichern.
Verifizieren: docker compose config -q gibt nichts aus. Fehlt ein Wert in der .env, bricht der Befehl mit dem Namen der Variable ab.
Schritt 2: Image bauen und Sprachmodell starten
docker compose build --pull
docker compose up -d --pull always llama
docker compose ps
docker compose run --rm --no-deps graphify --version
Der Bau dauerte im Test 54 Sekunden. Beim ersten Start lädt llama.cpp das Modell (4,2 GiB), bis der Container „healthy“ meldete, vergingen 155 Sekunden. Im Log steht danach n_slots = 2, n_ctx_slot = 8192. Die Versionsabfrage antwortet mit:
graphify 0.9.93Verifizieren: docker compose ps zeigt llama als „Up“ und „healthy“, die Versionsabfrage nennt 0.9.93.
Schritt 3: Dateien ablegen und Graph erzeugen
Kopieren Sie Code, Markdown-Dokumentation und PDFs nach corpus/, etwa per git clone oder rsync. Graphify beachtet .gitignore und eine eigene .graphifyignore für Ordner wie node_modules/. Im Test lag dort ein kleines Python-Paket mit fünf Dateien, ein Notfallhandbuch als Markdown und ein Betriebskonzept als PDF. Dann erzeugen Sie den Graphen:
docker compose run --rm graphify extract /work/corpus --backend openai \
  --out /work/out --token-budget 2000 --max-concurrency 2
Code wertet Graphify lokal per Syntaxbaum aus, nur Markdown und PDF gehen an das Sprachmodell. --max-concurrency 2 passt zu den zwei Slots von llama.cpp. Ein Auszug aus der Ausgabe im Test:
[graphify extract] found 5 code, 1 docs, 1 papers, 0 images
[graphify extract] AST extraction on 5 code files...
[graphify extract] semantic extraction on 2 files via openai...
[graphify extract] chunk 1/1 done
[graphify] WARNING: 1/2 dispatched file(s) produced no nodes and are absent from the graph: betriebskonzept.pdf. The model returned a response but omitted them; a re-run will retry them.
[graphify extract] wrote /work/out/graphify-out/graph.json: 33 nodes, 44 edges, 8 communities
Der Lauf dauerte 172 Sekunden. Das Notfallhandbuch kam im Graphen an, das PDF ließ das kleine Gemma-Modell aus. Graphify meldet solche Lücken ausdrücklich und empfiehlt in der ausführlichen Meldung ein kleineres --token-budget, damit das Modell kleinere Abschnitte bekommt. Im Ordner out/graphify-out liegen danach graph.json (der ganze Graph), manifest.json (Fingerabdrücke der Dateien) und der Ordner cache mit den Ergebnissen des Sprachmodells.
Verifizieren: jq '.nodes|length' out/graphify-out/graph.json zählt die Knoten, im Test 33. Knoten aus den Dokumenten zählt jq '[.nodes[]|select((.source_file//"")|test("docs/"))]|length' out/graphify-out/graph.json, im Test 9.
Schritt 4: Graph abfragen
Drei Befehle decken die meisten Fragen ab: query sucht zu einer Frage den passenden Ausschnitt, explain zeigt einen Knoten mit seinen Verbindungen, path den kürzesten Weg zwischen zwei Knoten. Ein Sprachmodell brauchen sie nicht.
docker compose run --rm --no-deps graphify query "Wer kontrolliert die Sicherung des Dateiservers?"
docker compose run --rm --no-deps graphify explain "sichere_dateiserver()"
docker compose run --rm --no-deps graphify path "sichere_dateiserver()" "NasZiel"
Die Ausgabe von explain im Test:
Node: sichere_dateiserver()
  ID:        itbetrieb_sicherung_sichere_dateiserver
  Source:    itbetrieb/sicherung.py L7
  Type:      code
  Community: 1
  Degree:    6

Connections (6):
  --> NasZiel [calls] [EXTRACTED] itbetrieb/sicherung.py:L8
  <-- sicherung.py [contains] [EXTRACTED] itbetrieb/sicherung.py:L7
  --> schreibe_protokoll() [calls] [EXTRACTED] itbetrieb/sicherung.py:L13
  --> sende_warnung() [calls] [EXTRACTED] itbetrieb/sicherung.py:L10
  --> .kopiere() [calls] [INFERRED] itbetrieb/sicherung.py:L12
  --> .pruefe_erreichbar() [calls] [INFERRED] itbetrieb/sicherung.py:L9
Jede Kante trägt eine Herkunft: EXTRACTED steht so in der Quelle, INFERRED hat Graphify aufgelöst, im Test etwa den Aufruf ziel.kopiere(), den es der Methode von NasZiel zuordnete. So sehen Sie, worauf sich eine Antwort stützt. path fand den direkten Weg sichere_dateiserver() --calls [EXTRACTED]--> NasZiel. Mit Containerstart dauerte eine Abfrage 1292 ms. Gruppen eng verbundener Knoten (Communities) benennt extract noch nicht. Das erledigt label mit dem Sprachmodell und schreibt dabei den Bericht GRAPH_REPORT.md, im Test in 73 Sekunden. Das Modell vergab englische Namen wie „NAS Backup and Recovery“:
docker compose run --rm graphify label . --backend=openai --max-concurrency=2Verifizieren: Die Befehle enden mit Exitcode 0. Im Test endete ein unbekannter Name mit 4. explain "sichere_dateiserver" ohne Klammern endete mit 3 und listete zwei Kandidaten auf, weil der Name auch im Notfallhandbuch steht.
Schritt 5: Graph im Browser ansehen
Erzeugen Sie die interaktive Grafik und die Architekturansicht, dann starten Sie Webserver und MCP-Server:
docker compose run --rm --no-deps graphify export html
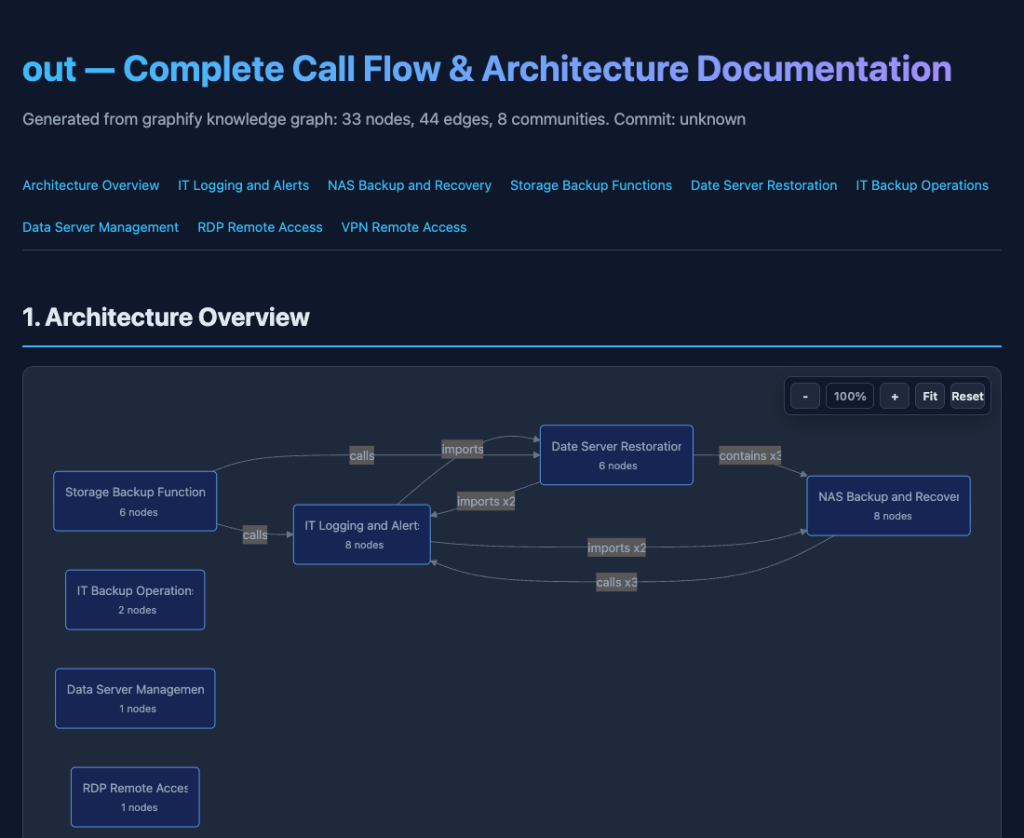
docker compose run --rm --no-deps graphify export callflow-html --output /work/out/graphify-out/callflow.html
docker compose up -d --pull always
Die Grafik öffnen Sie über einen SSH-Tunnel mit ssh -L 8766:127.0.0.1:8766 benutzer@server und http://localhost:8766 oder über den Reverse Proxy, etwa graphify.example.com mit Ziel 127.0.0.1:8766 (ein Proxy im eigenen Container erreicht 127.0.0.1 des Hosts nicht). Der Graph enthält Namen und Inhalte aus Ihren Quellen, schalten Sie im Proxy eine Anmeldung davor. Die Bibliotheken für die Darstellung lädt der Browser aus dem Internet (im Test vis-network 9.1.6 von unpkg.com und Mermaid 11 von cdn.jsdelivr.net), die Graphdaten stecken in der HTML-Datei selbst.
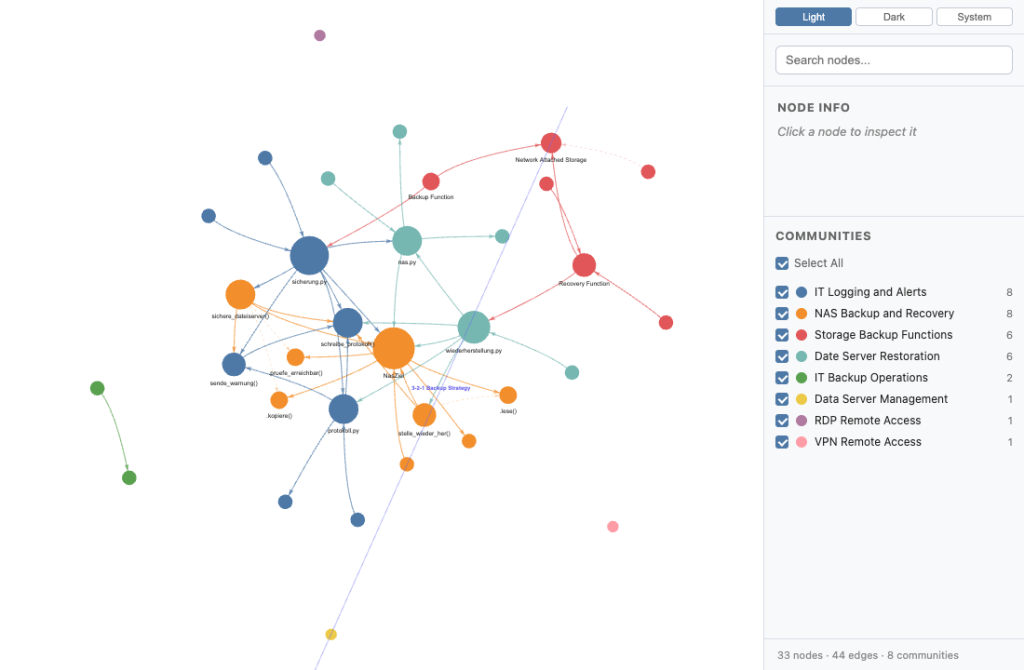
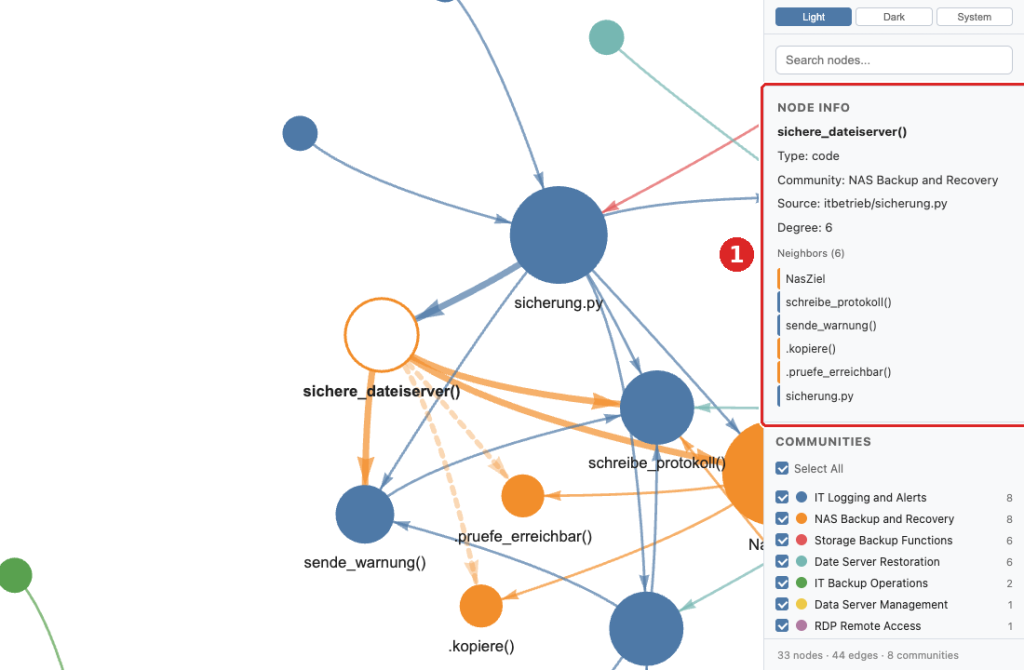
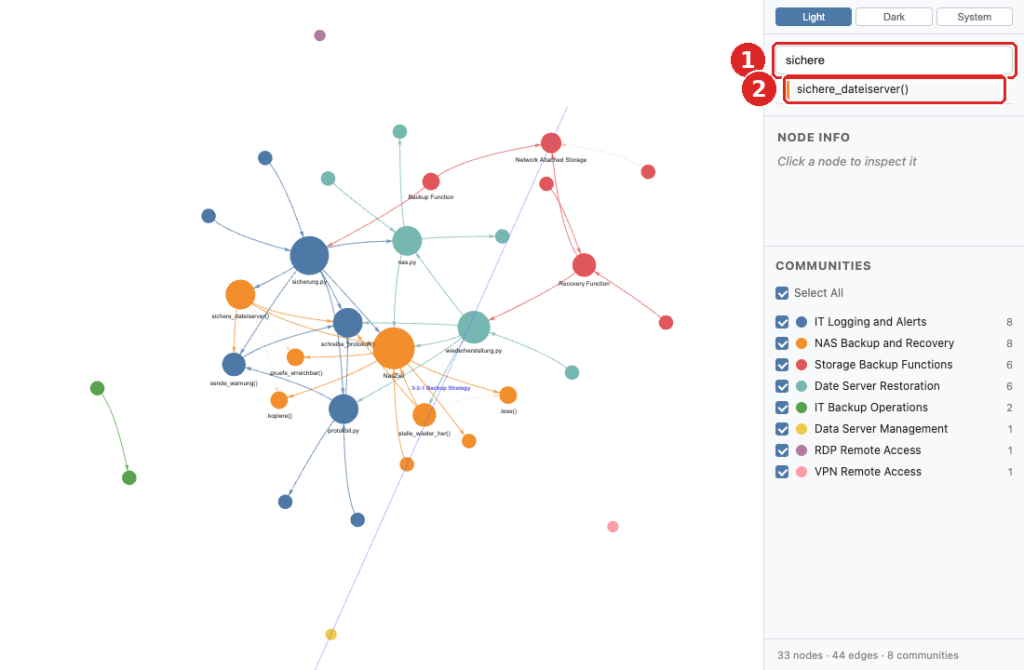
Ein Klick auf einen Knoten zeigt Quelle, Typ und Nachbarn, die Suche springt zu einem Namen.
Die Architekturansicht unter /callflow.html fasst die Communities als Diagramme zusammen.
Verifizieren: curl -s -o /dev/null -w '%{http_code}' http://127.0.0.1:8766/graph.html liefert 200, /graph.json dagegen 404.
Schritt 6: KI-Agenten per MCP anbinden
Der MCP-Server bietet zehn Werkzeuge, darunter query_graph, get_neighbors, shortest_path und graph_stats. Für Claude Code lautet die Anbindung laut dessen Dokumentation so, den Schlüssel lesen Sie aus der .env:
export GRAPHIFY_API_KEY=$(grep '^GRAPHIFY_API_KEY=' .env | cut -d= -f2)
claude mcp add --transport http graphify http://127.0.0.1:8765/mcp \
  --header "Authorization: Bearer $GRAPHIFY_API_KEY"
Im Test meldete sich der Server nach dem MCP-Handshake als {"name":"graphify","version":"0.9.93"} mit 10 Werkzeugen. graph_stats antwortete:
Nodes: 33
Edges: 44
Communities: 8
EXTRACTED: 91%
INFERRED: 9%
AMBIGUOUS: 0%
Nach einem neuen extract liest der Server graph.json bei der nächsten Abfrage neu ein. Im Test kam ein weiteres Modul hinzu, nach extract meldete graph_stats in derselben Sitzung 36 statt 33 Knoten, ohne dass der Container neu startete.
Verifizieren: Ohne oder mit falschem Schlüssel antwortet /mcp mit HTTP 401 und {"error": "unauthorized"}, mit Schlüssel liefert der Handshake die Werkzeugliste.
Schritt 7: Backup
Gesichert wird der Ausgabeordner. Er enthält neben dem Graphen den Cache mit den Ergebnissen des Sprachmodells, ohne ihn rechnet ein neuer Lauf alle Dokumente noch einmal durch. Die Quellen in corpus/ sichern Sie dort, wo sie herkommen, die .env gehört in den Passwortmanager.
tar czf backups/graphify-$(date +%F).tar.gz out/graphify-out
tar tzf backups/graphify-$(date +%F).tar.gz | head
Verifizieren: tar tzf listet graph.json, manifest.json und die Dateien unter cache/, im Test 33 Einträge.
Schritt 8: Wiederherstellung nach Totalverlust
Verschieben Sie den beschädigten Ausgabeordner zur Seite, statt ihn zu löschen, und setzen Sie den Namen der jüngsten Sicherung aus ls -lt backups/ ein:
docker compose stop mcp web
sudo mv out/graphify-out out/graphify-out.defekt
sudo tar xzf backups/graphify-JJJJ-MM-TT.tar.gz
docker compose start mcp web
sudo tar stellt die Besitzrechte von UID 1000 wieder her. Ist der ganze Server weg, richten Sie ihn nach Schritt 1 und 2 neu ein, nehmen die .env aus dem Passwortmanager und entpacken die Sicherung im Projektordner.
Verifizieren: jq '.nodes|length' out/graphify-out/graph.json nennt dieselbe Zahl wie vor dem Verlust, im Test 36 vor und nach dem Verlust (mit dem zusätzlichen Modul aus Schritt 6), und graph_stats per MCP stimmt überein. Ein erneutes extract nutzte den wiederhergestellten Cache und war nach 4 Sekunden fertig: incremental summary: 8 files cached/unchanged, 0 re-extracted, 0 deleted
Schritt 9: Update auf eine neue Version
Im Test lief das Update von 0.9.92 auf 0.9.93 mit vorhandenem Graphen. Setzen Sie statt X.Y.Z die neue Nummer aus den Release Notes ein, sichern Sie vorher wie in Schritt 7:
sed -i 's/^GRAPHIFY_VERSION=.*/GRAPHIFY_VERSION=X.Y.Z/' .env
docker compose build --pull
docker compose up -d
docker compose run --rm --no-deps graphify --version
docker compose run --rm graphify extract /work/corpus --backend openai \
  --out /work/out --token-budget 2000 --max-concurrency 2
Im Test erkannte der erste Lauf nach dem Update alle sieben Dateien als unverändert und schrieb den Graphen nach 3 Sekunden neu: incremental summary: 7 files cached/unchanged, 0 re-extracted, 0 deleted. Die Sicherung aus 0.9.92 ließ sich unter 0.9.93 ebenfalls zurückspielen.
Verifizieren: jq -r '.graph.graphify_version' out/graphify-out/graph.json nennt die neue Version, im Test 0.9.93, und graph_stats per MCP meldet dieselben Zahlen wie vor dem Update.
Troubleshooting
| Symptom | Ursache und Lösung |
|---|---|
chunk of 3 exceeded context at depth 0 (BadRequestError); splitting in half and retrying | Ein Abschnitt ist größer als der Kontext je Slot (8.192 Token), im llama-Log steht request (15411 tokens) exceeds the available context size (8192 tokens). Im Test mit --token-budget 16000 und einem großen Dokument provoziert, das Halbieren und Wiederholen lief dann länger als zehn Minuten. Budget wie in Schritt 3 lassen oder LLAMA_ARG_CTX_SIZE erhöhen. |
chunk 1/1 failed: Connection error. | Sprachmodell nicht erreichbar, im Test bei gestopptem llama-Container, extract endete mit Exitcode 1. docker compose ps und docker compose logs llama prüfen. |
required variable GRAPHIFY_API_KEY is missing a value: GRAPHIFY_API_KEY fehlt in .env | Die Zeile fehlt in der .env oder ist leer, Wert ergänzen. |
No node matching 'Druckerwarteschlange' found. | Kein Knoten mit diesem Namen (Exitcode 4). Schreibweise aus der Grafik oder graphify query übernehmen. |
Häufige Fragen
Braucht Graphify immer ein Sprachmodell?
Nein. Mit extract --code-only wertet Graphify laut Dokumentation nur Code aus, lokal und ohne Modell. Dokumente, PDFs und Bilder überspringt es dann.
Geht es statt llama.cpp mit Ollama oder einem Cloud-Dienst?
Ja. Laut Dokumentation unterstützt Graphify unter anderem Claude, Gemini, OpenAI, DeepSeek, Kimi, Ollama, Bedrock und Azure. Bei Cloud-Diensten verlassen die Dokumente Ihr Netz, bei Kunden- oder Personaldaten eine Frage für den Datenschutz.
Worin unterscheidet sich Graphify von RAG mit Vektordatenbank?
RAG-Werkzeuge wie AnythingLLM suchen ähnliche Textabschnitte über Vektoren. Graphify speichert laut README keine Embeddings, sondern Beziehungen mit Herkunft. Das hilft bei Fragen nach Zusammenhängen, etwa wer eine Funktion aufruft oder welches Dokument sie beschreibt.
Wie halte ich den Graphen aktuell?
Führen Sie extract wie in Schritt 3 nach Änderungen erneut aus. Unveränderte Dokumente kommen aus dem Cache, nur Neues und Geändertes geht an das Sprachmodell.
Fazit
Graphify macht aus Code und Dokumentation einen Graphen, den Agenten und Menschen gezielt befragen, statt Dateien zu durchsuchen. Der Code-Teil braucht kein Modell, Dokumente kosten mit lokalem Modell auf CPU spürbar Zeit, und ein sehr kleines Modell wie Gemma 4 E2B lässt auch einmal eine Datei aus. Wichtigste Stellschraube ist das Verhältnis von Token-Budget, Antwortlänge und Kontext je Slot.
Weiterführende Anleitungen und Quellen
- Docker Compose unter Linux: Grundlage für Selfhosting
- Docker Compose absichern: Secrets, Healthchecks, Non-Root
- Hindsight mit Docker: Gedächtnis für KI-Agenten mit llama.cpp
- Caddy als Reverse Proxy mit automatischem HTTPS
- Graphify auf GitHub
- Release Notes Graphify 0.9.93
- Paket graphifyy auf PyPI
- Dokumentation: Extraktion ohne IDE
- Dokumentation: MCP-Server über HTTP
- Dokumentation: Konfiguration