Claude Opus 5.5 vorgestellt: mehr Leistung bei 40 Prozent weniger Kosten
Anthropic hat Claude Opus 5.5 veröffentlicht, das erste Modell der neuen 5.5-Familie. Es soll bei den meisten Aufgaben das Niveau von Fable 5.1 erreichen und dabei 40 Prozent weniger kosten als Opus 5. Cache-Reads werden um 60 Prozent günstiger. Wir ordnen Preise, Benchmarks und Sicherheitsaussagen für den praktischen Einsatz ein.
Anthropic hat am 20. September 2026 Claude Opus 5.5 vorgestellt, das erste Modell der neuen Claude-5.5-Familie. Die Kernaussage des Herstellers ist ungewöhnlich für eine Modellankündigung: Das neue Modell soll bei den meisten Aufgaben das Niveau von Claude Fable 5.1 erreichen und dabei 40 Prozent weniger kosten als Opus 5. Der Fokus liegt also nicht auf einem neuen Spitzenwert, sondern auf dem Verhältnis von Leistung zu Kosten.
Für Administratoren und Entwicklerteams, die KI-Agenten produktiv einsetzen, ist das der interessantere Hebel. Wer Modelle in automatisierten Abläufen nutzt, zahlt nicht für einen Benchmark-Rekord, sondern für jede einzelne Anfrage.
Was sich bei den Preisen ändert
Anthropic senkt die Preise über alle Token-Arten hinweg. Besonders deutlich fällt die Reduktion bei den Cache-Reads aus, die laut Hersteller den Großteil der Kosten bei agentischer Arbeit und beim Programmieren ausmachen.
| Preis je 1 Million Token | Claude Opus 5.5 | Claude Opus 5 | Ersparnis |
|---|---|---|---|
| Cache-Reads | 0,20 US-Dollar | 0,50 US-Dollar | 60 Prozent |
| Eingabe-Token | 4 US-Dollar | 5 US-Dollar | 20 Prozent |
| Ausgabe-Token | 20 US-Dollar | 25 US-Dollar | 20 Prozent |
| Cache-Writes | 5 US-Dollar | 6,25 US-Dollar | 20 Prozent |
Die genannten 40 Prozent Gesamtersparnis ergeben sich laut Anthropic nicht allein aus dem niedrigeren Token-Preis. Das Modell benötigt zusätzlich weniger Token pro Aufgabe. Beide Effekte zusammen führen zu dem Wert, der sich auf typische Arbeitslasten bezieht, nicht auf jeden Einzelfall.
Ergänzend bietet Anthropic einen Fast Mode in Claude Code und auf der Claude-Plattform an, der bis zu 2,5-fache Geschwindigkeit liefern soll. Er kostet 8 US-Dollar je Million Eingabe-Token und 40 US-Dollar je Million Ausgabe-Token, also den doppelten Standardpreis. Die Ausgabe erfolgt nach Herstellerangaben zudem grundsätzlich über 30 Prozent schneller als bei Opus 5.
Für Abonnenten der Pro-, Max-, Team- und platzbasierten Enterprise-Tarife erhöht Anthropic außerdem die Fünf-Stunden-Nutzungsgrenzen. Abonnenten erhalten zusätzlich eine Rücksetzung des Ratenlimits, die sich aufsparen und zu einem selbst gewählten Zeitpunkt einsetzen lässt.
Die Benchmark-Werte im Vergleich
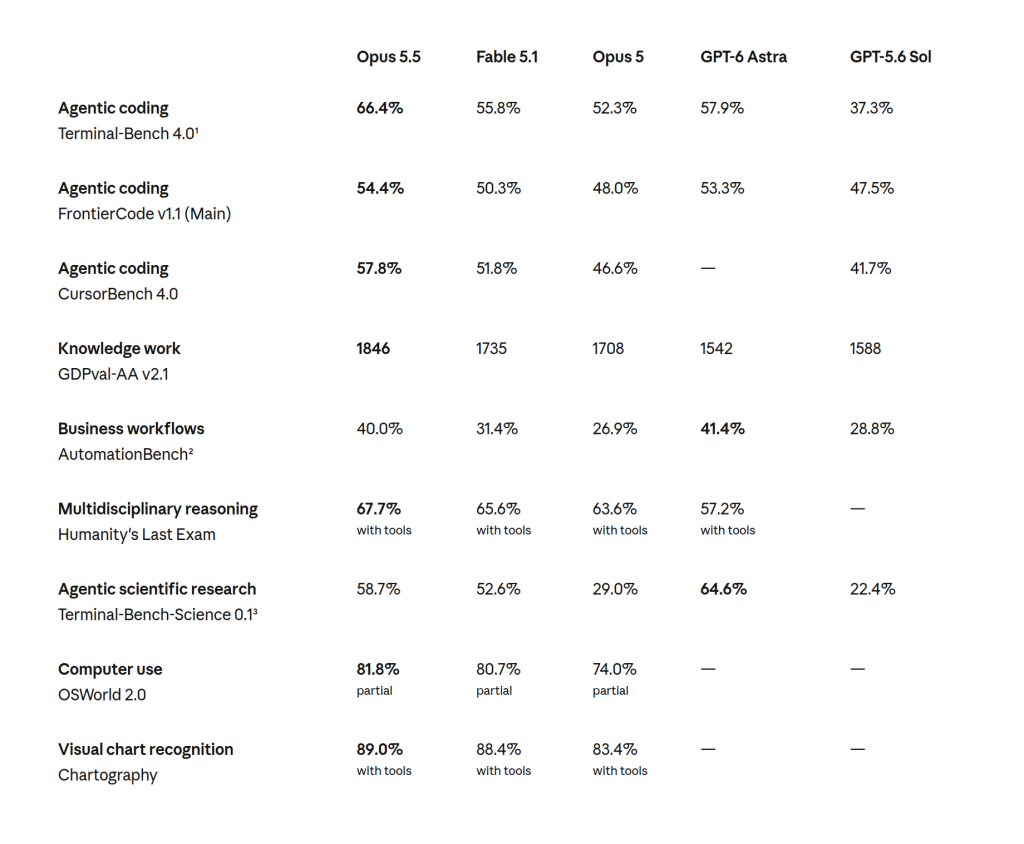
Anthropic stellt Opus 5.5 vier Modellen gegenüber: dem eigenen Vorgänger Opus 5, dem hauseigenen Fable 5.1 sowie GPT-6 Astra und GPT-5.6 Sol von OpenAI.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 Prozent | 55,8 Prozent | 52,3 Prozent | 57,9 Prozent | 37,3 Prozent |
| FrontierCode v1.1 (Main) | 54,4 Prozent | 50,3 Prozent | 48,0 Prozent | 53,3 Prozent | 47,5 Prozent |
| CursorBench 4.0 | 57,8 Prozent | 51,8 Prozent | 46,6 Prozent | kein Wert | 41,7 Prozent |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0 Prozent | 31,4 Prozent | 26,9 Prozent | 41,4 Prozent | 28,8 Prozent |
| Humanity's Last Exam | 67,7 Prozent | 65,6 Prozent | 63,6 Prozent | 57,2 Prozent | kein Wert |
| Terminal-Bench-Science 0.1 | 58,7 Prozent | 52,6 Prozent | 29,0 Prozent | 64,6 Prozent | 22,4 Prozent |
| OSWorld 2.0 | 81,8 Prozent | 80,7 Prozent | 74,0 Prozent | kein Wert | kein Wert |
| Chartography | 89,0 Prozent | 88,4 Prozent | 83,4 Prozent | kein Wert | kein Wert |
Bemerkenswert ist, dass Opus 5.5 nicht überall vorn liegt. Bei AutomationBench (41,4 gegen 40,0 Prozent) und bei Terminal-Bench-Science (64,6 gegen 58,7 Prozent) führt GPT-6 Astra. Anthropic stellt diese beiden Werte in der eigenen Tabelle sichtbar dar, statt sie wegzulassen.
Ebenso offen geht der Hersteller mit der Aussagekraft der Zahlen um. Im Originaltext heißt es, auf diesem Fähigkeitsniveau seien Benchmark-Abstände ein weniger verlässlicher Hinweis auf Unterschiede in der Praxis geworden. Der Abstand zwischen Opus 5.5 und Fable 5.1 sei im eigenen Einsatz geringer, als die Werte nahelegen.
Wichtige Einschränkungen zu den Messwerten
Anthropic nennt mehrere Punkte, die bei der Bewertung zu beachten sind:
- Der Standardfehler bei Terminal-Bench 4.0 liegt bei plus/minus 2,6 Punkten für Opus 5.5 und plus/minus 1,6 bis 2 Punkten für die anderen Claude-Modelle. Bei Terminal-Bench-Science sind es plus/minus 3,5 bis 5 Punkte je Modell.
- Die Werte zu GPT-6 Astra und GPT-5.6 Sol stammen aus Veröffentlichungen von OpenAI, nicht aus eigenen Messungen.
- Die AutomationBench-Werte wurden von Zapier erhoben, nicht von Anthropic.
- Opus 5.5 wurde mit aktivierten Schutzmechanismen bewertet. Wo diese eingriffen, übernahmen ältere Modelle die Aufgabe, was die Werte nach Herstellerangaben eher senkt.
Leistung und Kosten im Verhältnis
Das aussagekräftigere Bild liefert die Gegenüberstellung von Genauigkeit und Kosten je Versuch. Anthropic zeigt dafür Diagramme mit logarithmischer Kostenachse.
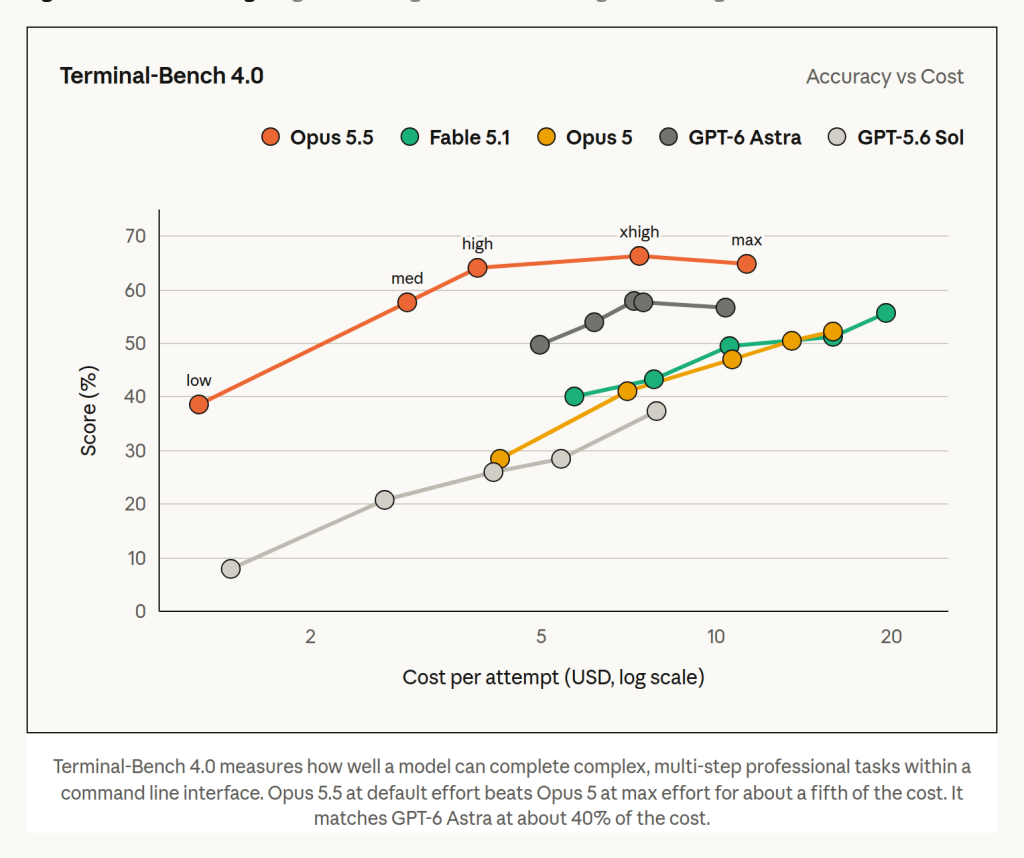
Die vom Hersteller genannten Vergleichspunkte:
- Bei FrontierCode schlägt Opus 5.5 auf Standardstufe GPT-6 Astra bei etwa 20 Prozent der Kosten je Aufgabe.
- Bei Terminal-Bench 4.0 erreicht es das Niveau von Astra für rund 40 Prozent der Kosten. Gegenüber Opus 5 auf höchster Stufe genügt etwa ein Fünftel der Kosten.
- Bei CursorBench liegt es 11 Punkte über GPT-5.6 Sol, bei etwa einem Drittel der Kosten.
- Bei GDPval-AA schlägt Opus 5.5 auf mittlerer Standardstufe GPT-6 Astra auf höchster Stufe, für etwa ein Fünftel der Kosten je Aufgabe.
Was das in der Praxis bedeutet
Anthropic nennt mehrere nachvollziehbare Beispiele aus internen Tests und von frühen Testern.
Ein Tester schloss eine Code-Migration über 680.000 Zeilen in weniger als einem Tag ab. Ein anderer prüfte und korrigierte eine Codebasis mit 200.000 Zeilen in unter drei Stunden, wofür Opus 5 über 20 Stunden benötigte und die 2,5-fache Token-Menge verbrauchte.
In einem internen Versuch sollten Opus 5.5 und Fable 5.1 die Lastverteilungssoftware HAProxy von C nach Rust übersetzen. Beide Ergebnisse bestanden nahezu alle Regressionstests von HAProxy. Opus 5.5 benötigte dafür 9,5 Stunden gegenüber 12 Stunden bei Fable 5.1 und kostete 51 Prozent weniger.
Bei der Aufgabe, die Ladezeiten aller Seiten einer Web-Anwendung zu verkürzen, war Opus 5.5 in 39 von 40 Durchläufen erfolgreich. Opus 5 erzielte kleinere Verbesserungen, veränderte dabei aber das Verhalten der Anwendung.
Aus dem Kreis der frühen Tester äußerten sich unter anderem GitHub, Spotify, Lovable und Optiver. GitHub berichtet, Opus 5.5 habe in Tests mit GitHub Copilot CLI und Visual Studio Code zu den sparsamsten gemessenen Modellen bei Token und Arbeitsschritten gehört und in VS Code mehr Terminal-Aufgaben gelöst als Opus 5, bei weniger als der Hälfte der Schritte. Optiver gibt an, die Kosten der betreffenden Arbeitslast seien um 40 bis 50 Prozent gesunken.
Sicherheit und Schutzmechanismen
Opus 5.5 ist nach Angaben von Anthropic die erste Veröffentlichung seit dem eigenen Aufruf, das Tempo an der Leistungsgrenze zu drosseln. Externe Prüfer, darunter Frontier Design und METR, testeten das Modell vor der Freigabe.
Im automatisierten Verhaltensaudit, dem nach Herstellerangaben umfassendsten eigenen Test zur Zielausrichtung, erzielt Opus 5.5 die besten bisher gemessenen Werte. Es soll deutlich seltener als die letzten Modelle schwer umkehrbare Handlungen ausführen oder die gesetzten Grenzen überschreiten. Gegenüber Prompt-Injection ist es nach eigenen Tests widerstandsfähiger als Opus 5. In einer Messung des Sicherheitsunternehmens Gray Swan teilt es sich mit Fable 5.1 die niedrigste Erfolgsquote für Prompt-Injection aller getesteten Modelle.
Weil Opus 5.5 in den Bereichen Biologie und Cybersicherheit mit Claude Mythos 5.1 vergleichbar ist, gelten ähnliche Schutzmechanismen wie bei Fable 5.1. Geprüfte Organisationen können sich für das Life Sciences Verification Program bewerben, um das Modell für biologische Forschung zu nutzen. Das Cyber Verification Program soll in den kommenden Wochen erweitert werden.
Für den Einsatz in Unternehmensumgebungen nennt Anthropic drei Bausteine: einen Klassifikator, der jede Aktion vor der Ausführung prüft, eine quelloffene Sandbox, die Sicherheitsteams selbst prüfen können, und eine Code-Überprüfung, die Schwachstellen vor dem Zusammenführen erkennen soll.
Anthropic schränkt die eigenen Aussagen dabei ausdrücklich ein. Die Tests zur Zielausrichtung wurden auf längere Aufgaben, unlösbare Aufgaben und an realen Vorfällen orientierte Szenarien ausgeweitet, dennoch bestünden weiterhin Grenzen.
Verständlichkeit als erklärtes Ziel
Ein eigener Abschnitt der Ankündigung widmet sich der Art, wie das Modell schreibt. Frühe Tester fanden die Ausgaben klarer und leichter nachvollziehbar, was laut Anthropic auf häufige Kritik an Opus 5 eingeht. Das Modell stelle die wichtigsten Informationen voran.
Anthropic ordnet das ausdrücklich als Sicherheitsvorteil ein, nicht nur als Frage des Stils: Arbeit, die sich leichter nachvollziehen lässt, lässt sich auch leichter überprüfen. Für den praktischen Einsatz ist das ein nachvollziehbarer Punkt, denn bei langen automatisierten Abläufen ist die Nachvollziehbarkeit der Zwischenschritte oft wichtiger als das Endergebnis.
Für wen ist das relevant?
Für Administratoren und kleine IT-Teams ergeben sich drei konkrete Ansatzpunkte.
Wer Claude bereits über die API nutzt, sollte die eigenen Kosten nachrechnen statt die 40 Prozent zu übernehmen. Entscheidend ist der Anteil der Cache-Reads an der eigenen Abrechnung, denn dort ist die Senkung mit 60 Prozent am größten. Bei Arbeitslasten mit wenig Caching fällt die Ersparnis näher an den 20 Prozent der übrigen Token-Arten.
Wer den Fast Mode erwägt, sollte beachten, dass er den doppelten Standardpreis kostet. Das lohnt sich bei interaktiver Arbeit, bei der Wartezeit teuer ist, nicht aber bei Aufgaben, die ohnehin im Hintergrund laufen.
Wer Agenten mit Zugriff auf eigene Systeme betreibt, für den sind die Sicherheitsaussagen relevanter als die Benchmark-Werte. Ein Modell, das seltener schwer umkehrbare Handlungen ausführt und widerstandsfähiger gegen Prompt-Injection ist, senkt das Risiko messbar. Eine Absicherung durch Berechtigungen und Sandboxing ersetzt es nicht. Wer eigene Modelle lokal betreibt, findet in unserem Beitrag zu Ollamas neuer Abrechnung pro Token einen Vergleichsmaßstab für die Kostenseite.
Claude Sonnet 5.5 und Claude Haiku 5.5 sollen in den kommenden Wochen folgen und viele der Verbesserungen bei Leistung, Effizienz und Sicherheit übernehmen. Für Teams, die heute Sonnet oder Haiku einsetzen, lohnt es sich daher, die Umstellung erst nach deren Erscheinen zu planen. Einen Überblick über die vorherige Generation bietet unser Artikel zu Claude Fable 5.1.
Einordnung
Die Ankündigung ist in einem Punkt ungewöhnlich: Anthropic wirbt weniger mit Spitzenwerten als mit Effizienz und relativiert die eigenen Benchmark-Zahlen sogar ausdrücklich. Zwei Werte, bei denen die Konkurrenz vorn liegt, bleiben sichtbar in der Tabelle.
Gleichzeitig gilt für alle genannten Zahlen, dass sie vom Hersteller stammen oder von Partnern im Rahmen eines frühen Zugangs erhoben wurden. Unabhängige Nachmessungen stehen aus. Die Aussagen zu Zeitersparnis und Kostensenkung beruhen auf einzelnen Testfällen, nicht auf einer breiten Erhebung.
Für die Praxis bleibt die nüchterne Empfehlung: Wer das Modell einsetzen will, sollte es an der eigenen typischen Arbeitslast messen und die tatsächlichen Kosten über einige Tage vergleichen, statt sich auf die genannten Prozentwerte zu verlassen.
Quellen
- Anthropic: Introducing Claude Opus 5.5, abgerufen am 20. September 2026
- Benchmark-Tabelle, Preistabelle und Diagramme: eigene Bildschirmaufnahmen der oben genannten Anthropic-Seite, abgerufen am 20. September 2026