Lokales RAG-System mit Qdrant und Embeddings selbst bauen: Schritt-für-Schritt-Anleitung
Lokales RAG mit Qdrant 1.19 und Ollama in Docker: Dokumente mit bge-m3 indexieren und Fragen mit einem kleinen Sprachmodell samt Quellenangabe beantworten, ohne Cloud und Grafikkarte.
Geprüft am 14.10.2026 · für Qdrant 1.19.2, Ollama 0.40.4
WerbelinksMit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Ein lokales RAG-System beantwortet Fragen zu Ihren eigenen Dokumenten, ohne dass Texte das Haus verlassen. RAG steht für Retrieval-Augmented Generation: Das System sucht zu jeder Frage die passenden Textabschnitte heraus und gibt sie einem Sprachmodell als Grundlage für die Antwort mit. Diese Anleitung baut den Stack mit Qdrant 1.19.2 als Vektordatenbank und Ollama 0.40.4 für Embeddings und Antworten in Docker auf. Zwei kurze Python-Skripte lesen PDF- und TXT-Dateien ein und stellen Fragen. Der Stack läuft auf der CPU, ohne Grafikkarte und ohne Cloud-Dienst.
Voraussetzungen
- Linux-Server oder Mini-PC mit x86_64 oder ARM64, Docker Engine und Compose-Plugin (siehe Docker installieren).
- 4 CPU-Kerne und 8 GB RAM. Im Test belegten die geladenen Modelle laut
ollama pszusammen rund 3,4 GB (bge-m3 1,2 GB, qwen2.5:3b 2,2 GB), Qdrant rund 140 MB. Größere Sprachmodelle wie Llama 3.1 8B brauchen 16 GB RAM oder eine Grafikkarte mit 8 GB VRAM. - Rund 10 GB freier Speicher: Modelle 3,1 GB, Images, Python-Umgebung und Index.
- Python 3.10 oder neuer mit
venvauf dem Host, alternativ ein Python-Container. - Ihre Dokumente als PDF mit Textebene oder als TXT in UTF-8. Gescannte PDFs ohne Textebene brauchen vorher eine Texterkennung.
Schritt 1: Qdrant und Ollama mit Docker Compose starten
Qdrant verlangt ohne Konfiguration keine Anmeldung. Deshalb binden Sie die Ports an 127.0.0.1 und setzen trotzdem einen API-Schlüssel, damit auch andere Container oder Benutzer auf dem Host nicht ungefragt lesen und schreiben. Legen Sie den Projektordner an und erzeugen Sie den Schlüssel:
mkdir -p ~/rag/dokumente && cd ~/rag
echo "QDRANT_API_KEY=$(openssl rand -hex 32)" > .env
chmod 600 .env
Dann compose.yaml:
services:
  qdrant:
    image: qdrant/qdrant:v1.19.2
    container_name: qdrant
    restart: unless-stopped
    ports:
      - "127.0.0.1:6333:6333"
      - "127.0.0.1:6334:6334"
    environment:
      - QDRANT__SERVICE__API_KEY=${QDRANT_API_KEY}
    volumes:
      - ./qdrant_storage:/qdrant/storage

  ollama:
    image: ollama/ollama:0.40.4
    container_name: ollama
    restart: unless-stopped
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
- ./ollama:/root/.ollama| Dienst | Image | Port | Daten |
|---|---|---|---|
| Qdrant | qdrant/qdrant:v1.19.2 | 6333 REST und Dashboard, 6334 gRPC | ./qdrant_storage |
| Ollama | ollama/ollama:0.40.4 | 11434 API | ./ollama (Modelle) |
docker compose up -d
docker compose ps
Läuft Ollama bereits auf dem Host, etwa nach der Anleitung Ollama mit Open WebUI, lassen Sie den Dienst ollama weg und nutzen die vorhandene Instanz.
Verifizieren: curl -s http://localhost:6333/healthz antwortet mit healthz check passed. curl -s -o /dev/null -w '%{http_code}' http://localhost:6333/collections liefert 401, mit Schlüssel (-H "api-key: $QDRANT_API_KEY" nach set -a; . ./.env; set +a) kommt {"result":{"collections":[]}. curl -s localhost:11434/api/version zeigt 0.40.4.
Schritt 2: Embedding-Modell und Sprachmodell laden
Embeddings sind Zahlenvektoren, die die Bedeutung eines Textabschnitts abbilden. Ähnliche Inhalte liegen im Vektorraum nahe beieinander, auch wenn andere Wörter verwendet werden. Für deutsche Dokumente brauchen Sie ein mehrsprachiges Modell. bge-m3 deckt über 100 Sprachen ab, erzeugt Vektoren mit 1024 Dimensionen und steht unter MIT-Lizenz. Das Antwortmodell qwen2.5:3b ist klein genug für die CPU und beherrscht Deutsch.
docker compose exec ollama ollama pull bge-m3
docker compose exec ollama ollama pull qwen2.5:3b
docker compose exec ollama ollama list
Die Downloads dauerten im Test zusammen gut zwei Minuten. Wer mehr RAM oder eine Grafikkarte hat, kann statt qwen2.5:3b ein größeres Modell wie qwen2.5:7b verwenden; das Embedding-Modell bleibt gleich.
Verifizieren: ollama list zeigt bge-m3:latest mit 1,2 GB und qwen2.5:3b mit 1,9 GB.
Schritt 3: Python-Umgebung einrichten
Die Skripte sprechen Qdrant über den offiziellen Python-Client und Ollama über dessen HTTP-API an. Mehr Bibliotheken braucht es nicht:
cd ~/rag
python3 -m venv .venv
. .venv/bin/activate
pip install requests qdrant-client==1.19.1 pypdf
set -a; . ./.env; set +a
Die letzte Zeile lädt den API-Schlüssel als Umgebungsvariable in die aktuelle Shell. Wiederholen Sie sie in jeder neuen Sitzung.
Verifizieren: pip list | grep -E 'qdrant|pypdf' zeigt qdrant-client 1.19.1 und pypdf, und echo ${#QDRANT_API_KEY} gibt 64 aus.
Schritt 4: Dokumente einlesen und indexieren
Lange Texte zerlegen Sie in überlappende Abschnitte (Chunks). Zu große Abschnitte verwässern die Suche, zu kleine reißen Zusammenhänge auseinander. 1000 Zeichen mit 150 Zeichen Überlappung sind ein guter Startwert für deutsche Fließtexte. Legen Sie ingest.py an:
import glob, os, uuid
import requests
from pypdf import PdfReader
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams

OLLAMA = os.getenv("OLLAMA_URL", "http://localhost:11434")
QDRANT = os.getenv("QDRANT_URL", "http://localhost:6333")
KEY = os.environ["QDRANT_API_KEY"]
MODELL = os.getenv("EMBED_MODEL", "bge-m3")
COLL = "meine_dokumente"


def texte():
    for pfad in sorted(glob.glob("dokumente/**/*", recursive=True)):
        if pfad.lower().endswith(".pdf"):
            for nr, seite in enumerate(PdfReader(pfad).pages, 1):
                yield pfad, nr, seite.extract_text() or ""
        elif pfad.lower().endswith(".txt"):
            yield pfad, 1, open(pfad, encoding="utf-8").read()


def chunks(text, groesse=1000, ueberlappung=150):
    text = " ".join(text.split())
    return [text[i:i + groesse] for i in range(0, len(text), groesse - ueberlappung)]


def embed(liste):
    r = requests.post(f"{OLLAMA}/api/embed", json={"model": MODELL, "input": liste}, timeout=600)
    r.raise_for_status()
    return r.json()["embeddings"]


stuecke = [(p, s, n, c) for p, s, t in texte() for n, c in enumerate(chunks(t))]
print(f"{len(stuecke)} Abschnitte")
q = QdrantClient(url=QDRANT, api_key=KEY)
if not q.collection_exists(COLL):
    dim = len(embed(["Test"])[0])
    q.create_collection(COLL, vectors_config=VectorParams(size=dim, distance=Distance.COSINE))
for i in range(0, len(stuecke), 32):
    teil = stuecke[i:i + 32]
    vektoren = embed([c for *_, c in teil])
    q.upsert(COLL, points=[
        PointStruct(id=str(uuid.uuid5(uuid.NAMESPACE_URL, f"{p}#{s}#{n}")), vector=v,
                    payload={"quelle": p, "seite": s, "text": c})
        for (p, s, n, c), v in zip(teil, vektoren)])
print("Indexierung abgeschlossen:", q.count(COLL).count, "Punkte")
Das Skript legt die Collection beim ersten Lauf mit der Vektorgröße des Modells und Kosinus-Distanz an. Jeder Abschnitt erhält eine feste ID aus Dateipfad, Seite und Nummer. Ein erneuter Lauf überschreibt deshalb vorhandene Einträge, statt sie doppelt anzulegen. Die Warnung Api key is used with an insecure connection erscheint, weil die Verbindung zu Qdrant unverschlüsselt über localhost läuft; solange der Port nur an 127.0.0.1 gebunden ist, ist das unkritisch.
cp /pfad/zu/ihren/dateien/*.pdf dokumente/
python ingest.py
Verifizieren: Die Ausgabe nennt die Zahl der Abschnitte und endet mit Indexierung abgeschlossen: N Punkte. Ein zweiter Lauf zeigt dieselbe Punktzahl. Zeigt das Skript 0 Abschnitte, liegen die Dateien nicht im Ordner dokumente oder haben eine andere Endung.
Schritt 5: Collection im Qdrant-Dashboard prüfen
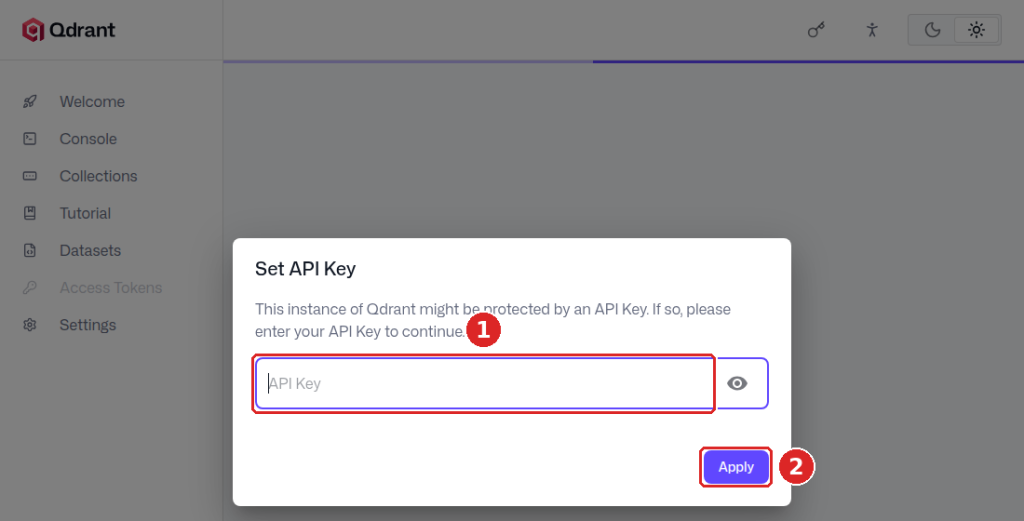
Qdrant bringt unter /dashboard eine Weboberfläche mit. Weil der Port nur an 127.0.0.1 hängt, öffnen Sie sie vom Arbeitsplatz aus über einen SSH-Tunnel: ssh -L 6333:localhost:6333 benutzer@server, dann im Browser http://localhost:6333/dashboard. Das Dashboard fragt nach dem API-Schlüssel aus der .env.
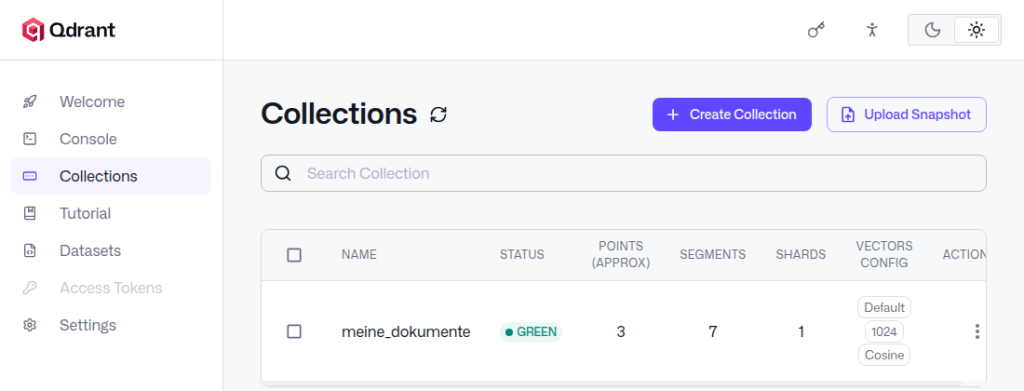
Unter „Points“ sehen Sie jeden Abschnitt mit Quelle, Seite und Textanfang. So erkennen Sie schnell, ob Umlaute korrekt angekommen sind und ob die Texterkennung einer PDF funktioniert hat.
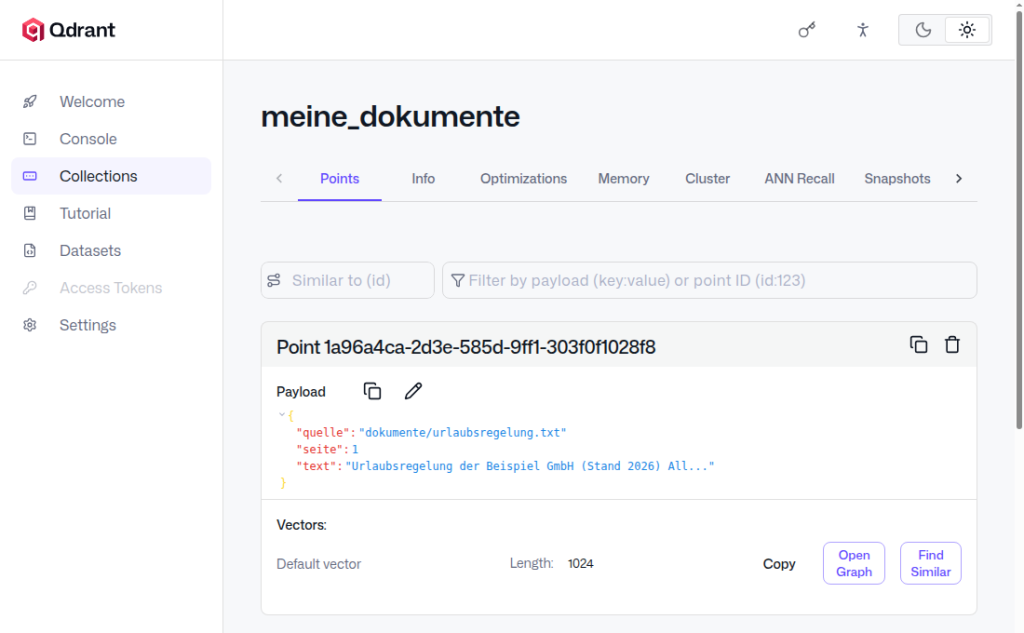
Verifizieren: Die Collection meine_dokumente steht auf GREEN, die Punktzahl entspricht der Ausgabe von ingest.py, und die Payloads zeigen lesbaren Text mit Umlauten.
Schritt 6: Fragen stellen
frage.py berechnet den Vektor der Frage, holt die vier ähnlichsten Abschnitte aus Qdrant und gibt sie dem Sprachmodell mit der Anweisung, nur daraus zu antworten:
import os, sys
import requests
from qdrant_client import QdrantClient

OLLAMA = os.getenv("OLLAMA_URL", "http://localhost:11434")
QDRANT = os.getenv("QDRANT_URL", "http://localhost:6333")
KEY = os.environ["QDRANT_API_KEY"]
LLM = os.getenv("LLM", "qwen2.5:3b")
frage = " ".join(sys.argv[1:]) or "Worum geht es in meinen Dokumenten?"

r = requests.post(f"{OLLAMA}/api/embed", json={"model": "bge-m3", "input": [frage]}, timeout=120)
treffer = QdrantClient(url=QDRANT, api_key=KEY).query_points(
    "meine_dokumente", query=r.json()["embeddings"][0], limit=4, with_payload=True).points
kontext = "\n\n".join(f"[{i}] {t.payload['text']}" for i, t in enumerate(treffer, 1))
prompt = ("Beantworten Sie die Frage ausschließlich anhand des Kontexts. Steht die Antwort "
          "nicht darin, schreiben Sie: Dazu enthalten die Dokumente keine Angabe.\n\n"
          f"Kontext:\n{kontext}\n\nFrage: {frage}")
r = requests.post(f"{OLLAMA}/api/chat", timeout=600, json={
    "model": LLM, "stream": False, "options": {"temperature": 0},
    "messages": [{"role": "user", "content": prompt}]})
print(r.json()["message"]["content"])
for i, t in enumerate(treffer, 1):
    print(f"Quelle {i}: {t.payload['quelle']} S. {t.payload['seite']} (Score {t.score:.3f})")
python frage.py "Wie viele Urlaubstage bekommen Vollzeitkräfte?"Im Test mit drei Beispieldokumenten (Urlaubsregelung, Serverraum-Handbuch, Reisekosten-PDF) antwortete das System auf diese Frage mit „Vollzeitkräfte erhalten 28 Erholungsurlaubstage pro Kalenderjahr“ und nannte die Urlaubsregelung als erste Quelle mit Score 0,708; die übrigen Dokumente lagen bei 0,35 bis 0,40. Die Frage nach der Kilometerpauschale fand die PDF-Datei, die Frage nach einem Geschäftsführer, der in keinem Dokument vorkommt, beantwortete das Modell mit „Dazu enthalten die Dokumente keine Angabe“. Die erste Antwort dauerte auf der CPU rund 12 Sekunden, weil Ollama die Modelle erst lädt; danach geht es schneller.
Verifizieren: Eine Frage zu einem Detail, das nur in einem Ihrer Dokumente steht, liefert die richtige Antwort, und „Quelle 1“ nennt genau diese Datei mit dem höchsten Score. Eine Frage ohne Bezug zu Ihren Dokumenten führt zu „Dazu enthalten die Dokumente keine Angabe“.
Schritt 7: Sichern und aktualisieren
Alle Vektoren und Payloads liegen in ./qdrant_storage. Sichern Sie das Verzeichnis bei gestopptem Qdrant, damit der Stand konsistent ist. Der Index lässt sich aus den Quelldokumenten jederzeit neu erzeugen; die Dokumente selbst gehören ohnehin in Ihre normale Datensicherung.
cd ~/rag
docker compose stop qdrant
tar czf qdrant-backup-$(date +%F).tar.gz qdrant_storage
docker compose start qdrant
Für ein Update tragen Sie die neuen Versionen in compose.yaml ein, lesen vorher die Release Notes von Qdrant und starten neu:
docker compose pull
docker compose up -d
pip install -U qdrant-client
Neue oder geänderte Dokumente legen Sie in dokumente/ ab und starten ingest.py erneut. Gelöschte Dateien bleiben im Index, bis Sie die Collection mit curl -X DELETE -H "api-key: $QDRANT_API_KEY" http://localhost:6333/collections/meine_dokumente entfernen und neu indexieren.
Verifizieren: tar tzf qdrant-backup-*.tar.gz | head listet Dateien unter qdrant_storage/. Nach einem Update zeigt curl -s localhost:6333 die neue Version, und die Punktzahl der Collection ist unverändert.
Typische Fehler
401 Unauthorizedvon Qdrant: Der API-Schlüssel fehlt in der Shell.set -a; . ./.env; set +aausführen.Connection refusedauf 6333 oder 11434: Container läuft nicht.docker compose psunddocker compose logs qdrantprüfen.model "bge-m3" not found: Modell nicht geladen. Schritt 2 wiederholen.- Dimensionsfehler beim Schreiben: Das Embedding-Modell wurde gewechselt, die Collection hat noch die alte Vektorgröße. Collection löschen und neu indexieren.
- Antworten passen nicht zu den Dokumenten: In Qdrant prüfen, ob die Payloads lesbaren Text enthalten. Bei gescannten PDFs liefert
extract_text()leere Seiten. Sonstlimitauf 6 bis 8 erhöhen oder kleinere Chunks wählen. - Verstümmelte Umlaute: TXT-Datei nicht in UTF-8 gespeichert. Mit
file datei.txtprüfen und miticonv -f latin1 -t utf-8umwandeln. - Speicher reicht nicht: Ollama hält Modelle nach einer Anfrage fünf Minuten im RAM. Kleineres Sprachmodell wählen oder die Variable
OLLAMA_KEEP_ALIVEkürzer setzen.
Häufige Fragen
Welches Embedding-Modell eignet sich für deutsche Texte?
Ein mehrsprachiges Modell. bge-m3 ist bei Ollama direkt verfügbar und für deutsche Texte geeignet. Wechseln Sie das Modell, müssen Sie neu indexieren, weil Vektoren verschiedener Modelle nicht vergleichbar sind.
Brauche ich eine Grafikkarte?
Nein. Embeddings und ein 3B-Modell laufen auf der CPU in akzeptabler Zeit. Eine Grafikkarte beschleunigt vor allem das Indexieren großer Dokumentmengen und größere Sprachmodelle.
Werden Daten an externe Dienste gesendet?
Nein. Qdrant und Ollama laufen lokal, nur der einmalige Download der Images und Modelle braucht Internet.
Kann ich LangChain oder LlamaIndex verwenden?
Ja, beide haben Integrationen für Qdrant und Ollama. Für den Einstieg sind die beiden Skripte übersichtlicher, weil jeder Schritt sichtbar bleibt und keine weiteren Abhängigkeiten nötig sind.
Fazit
Mit Qdrant, Ollama und zwei kurzen Skripten entsteht ein RAG-System, das Fragen zu internen Dokumenten mit Quellenangabe beantwortet und vollständig im eigenen Netz bleibt. Die wichtigsten Stellschrauben sind ein mehrsprachiges Embedding-Modell, sauberer Text in den Payloads und eine klare Anweisung an das Sprachmodell, nur aus dem Kontext zu antworten. Für mehr Qualität tauschen Sie zuerst das Sprachmodell gegen ein größeres, Index und Skripte bleiben dabei unverändert.