Speichergrenzen für Docker-Container: Wer stirbt zuerst bei 1 GB RAM?
Ohne Grenze riss ein undichter Container WordPress immer wieder mit, mit 256 MiB Grenze lief es fehlerfrei. Bei Überlast half erst die Begrenzung auf 8 Apache-Prozesse, die Speichergrenze allein nicht. Mit per oom_score_adj geschützter Datenbank kam der Server nach der Überlast nicht zurück.
Mit KI erstellt – redaktionelle Prüfung ausstehend
Werbung Mit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
Ohne Speichergrenzen teilen sich alle Docker-Container den gesamten RAM des Servers. Das geht gut, bis einer zu viel will. Dann muss der Linux-Kernel einen Prozess beenden, und er wählt nicht unbedingt den, der das Problem verursacht hat. Diese Anleitung setzt Grenzen pro Container mit Docker Compose und misst auf einem netcup VPS piko G11s mit einer vCPU und 1 GB RAM, was sie bewirken: einmal bei einem Container mit Speicherleck, einmal bei WordPress unter Überlast. Dazu kommt ein Versuch, die Datenbank über oom_score_adj zu schützen.
Dies ist Teil 6 der Reihe „Mini-Server“. WordPress läuft wie in Teil 3 mit MariaDB und Caddy.
Was Sie brauchen
- Einen Linux-Server mit Docker und Docker Compose, hier Ubuntu 24.04 auf dem Mini-Server aus Teil 1 mit Docker 29.9.3 und Compose 5.7.0.
- Für die Messung: WordPress mit MariaDB wie in Teil 3 und einen zweiten Rechner mit k6 als Lastgenerator wie in Teil 2. Lasttests nur auf eigenen Systemen.
- Zugang zur Server-Verwaltung Ihres Anbieters, um einen festgefahrenen Server hart neu zu starten.
Schritt 1: Nachsehen, wie viel jeder Container belegt
docker stats zeigt den Speicher jedes Containers. Steht in der Spalte nach dem Schrägstrich der gesamte RAM des Servers, hat der Container keine Grenze:
# docker stats --no-stream --format "table {{.Name}}\t{{.MemUsage}}"Verifizieren: Ohne Grenzen sah das auf dem Mini-Server so aus, jeder Container durfte bis zu 957 MiB nehmen:
NAME              MEM USAGE / LIMIT
mini-wp-wp-1      62.05MiB / 957.5MiB
mini-wp-db-1      123MiB / 957.5MiB
mini-wp-caddy-1   51.95MiB / 957.5MiB
Merken Sie sich die Werte unter Last, nicht im Leerlauf. Im Test brauchte der WordPress-Container bei zwei Aufrufen pro Sekunde rund 150 bis 170 MiB, MariaDB rund 130 MiB, Caddy rund 55 MiB. Als ein Speicherleck den Server ausbremste, wuchs WordPress auf 372 MiB, weil sich die Aufrufe stauten.
Schritt 2: Grenzen in Compose setzen
Die Grenze heißt in Compose mem_limit. Tragen Sie sie bei jedem Dienst ein, der wachsen kann. Für WordPress und MariaDB auf dem Mini-Server waren es dieselben Werte wie in Teil 3:
services:
  db:
    image: mariadb:11.4
    mem_limit: 256m
    # übrige Einstellungen wie bisher
  wp:
    image: wordpress:php8.3-apache
    mem_limit: 384m
    # übrige Einstellungen wie bisher
Danach legt Compose die betroffenen Container neu an:
# docker compose up -dLäuft auf dem Server Swap, etwa die Swapdatei aus Teil 5, darf ein Container mit mem_limit zusätzlich noch einmal so viel auslagern, wie die Grenze erlaubt. Soll er gar nicht auslagern, setzen Sie memswap_limit auf denselben Wert wie mem_limit. Der Wert ist die Summe aus RAM und Swap.
Verifizieren: docker stats zeigt jetzt die Grenze, docker inspect die Werte in Byte (Speicher und Speicher plus Swap):
NAME              MEM USAGE / LIMIT
mini-wp-wp-1      13.66MiB / 384MiB
mini-wp-db-1      83.53MiB / 256MiB
mini-wp-caddy-1   52.07MiB / 957.5MiB
# docker inspect -f '{{.Name}} {{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}' $(docker compose ps -q)/mini-wp-caddy-1 0 0
/mini-wp-db-1 268435456 536870912
/mini-wp-wp-1 402653184 805306368Schritt 3: Die Zahl der Apache-Prozesse begrenzen
Die Speichergrenze allein hilft bei Überlast nicht, das zeigt Ergebnis 2. Das WordPress-Image startet bis zu 150 Apache-Prozesse, die in 384 MiB nicht passen. Begrenzen Sie deshalb die Prozesse wie in Teil 3 auf 8, hier mit einer eigenen Datei mpm8.conf neben der compose.yaml:
<IfModule mpm_prefork_module>
	StartServers		 2
	MinSpareServers		 2
	MaxSpareServers		 8
	MaxRequestWorkers	 8
	MaxConnectionsPerChild   500
</IfModule>
Die Datei binden Sie im Dienst wp über die Standarddatei des Images:
services:
  wp:
    mem_limit: 384m
    volumes:
      - ./html:/var/www/html
      - ./mpm8.conf:/etc/apache2/mods-available/mpm_prefork.conf:ro
    # übrige Einstellungen wie bisher
Verifizieren: Nach docker compose up -d zeigt die Datei im Container die neue Obergrenze:
# docker compose exec wp grep MaxRequestWorkers /etc/apache2/mods-available/mpm_prefork.confMaxRequestWorkers 8Schritt 4: Herausfinden, wen es getroffen hat
Ob der Kernel einen Prozess beendet hat, steht im Kernel-Protokoll. Die Zeile davor verrät, ob der ganze Server voll war oder nur ein Container seine Grenze erreicht hat:
# journalctl -k | grep -E 'oom-kill:|Killed process'Bei einem vollen Server steht dort constraint=CONSTRAINT_NONE und Out of memory: Killed process, bei einer Container-Grenze constraint=CONSTRAINT_MEMCG und Memory cgroup out of memory: Killed process. Erreicht ein Container seine Grenze, meldet Docker das als oom. Beim vollen Server fehlte das Ereignis im Test zweimal von dreimal:
# docker events --filter type=container --filter event=oomVerifizieren: So sah ein Treffer am Leck-Container mit Grenze aus (gekürzt):
oom-kill:constraint=CONSTRAINT_MEMCG,…,oom_memcg=/system.slice/docker-d0d925df3b84….scope,…,task=python3,pid=3304,uid=0
Memory cgroup out of memory: Killed process 3304 (python3) total-vm:280284kB, anon-rss:260488kB, file-rss:2304kB, shmem-rss:0kB, UID:0 pgtables:580kB oom_score_adj:0
Verlassen Sie sich nicht auf docker inspect -f '{{.State.OOMKilled}}'. Nach einem Neustart durch die Restart-Policy stand dort im Test wieder false, obwohl der Container 12-mal beendet worden war. {{.RestartCount}} zählt die Neustarts dagegen mit.
So wurde gemessen
Auf dem Server lief WordPress mit MariaDB und Caddy im Zustand aus Teil 3, ohne Seiten-Cache. Jeder Lauf startete nach einem Neustart, nach dem Start waren rund 530 bis 540 MiB verfügbar. Ein Skript schrieb alle 2 Sekunden, unter Last seltener, den verfügbaren Speicher, den Speicher jedes Containers und die Zahl der OOM-Kills mit. Dazu kamen das Kernel-Protokoll und docker events.
Test 1, Speicherleck: k6 rief vom zweiten Server 14 Minuten lang zwei Aufrufe pro Sekunde ab, verteilt auf 21 WordPress-Seiten. Nach 2 Minuten startete ein zusätzlicher Container mit restart: unless-stopped, in dem ein Python-Programm alle 15 Sekunden weitere 64 MiB belegt, wie ein Dienst mit Speicherleck. Nach 10 Minuten wurde der Container entfernt. Ohne Swap lief das Leck einmal ohne und einmal mit Grenze von 256 MiB am Leck-Container, mit der Swapdatei aus Teil 5 einmal mit Grenze und einmal mit Grenze und gesperrtem Swap. Der Leck-Container startete mit docker run und den Optionen --memory und --memory-swap, sie entsprechen mem_limit und memswap_limit. WordPress und MariaDB liefen dabei ohne Grenze.
Test 2, Überlast: Nach 30 Sekunden Aufwärmen mit einem Aufruf pro Sekunde schickte k6 zwei Minuten lang 10 Aufrufe pro Sekunde, wie in Teil 5. Der Server schafft ohne Cache rund 4. Ein Skript auf einem dritten Rechner fragte ab dem Aufwärmen 24 Minuten lang, also bis rund 21 Minuten nach Lastende, alle 15 Sekunden per SSH den Zustand ab und rief eine Seite auf. Gemessen wurde ohne Swap: nur mit Grenzen (WordPress 384 MiB, MariaDB 256 MiB), mit denselben Grenzen und 8 Apache-Prozessen und ohne Grenzen mit geschützter Datenbank (oom_score_adj: -800). Die Werte ohne Grenzen stammen aus Teil 5, gleicher Aufbau.
Ergebnis 1: Ein Speicherleck
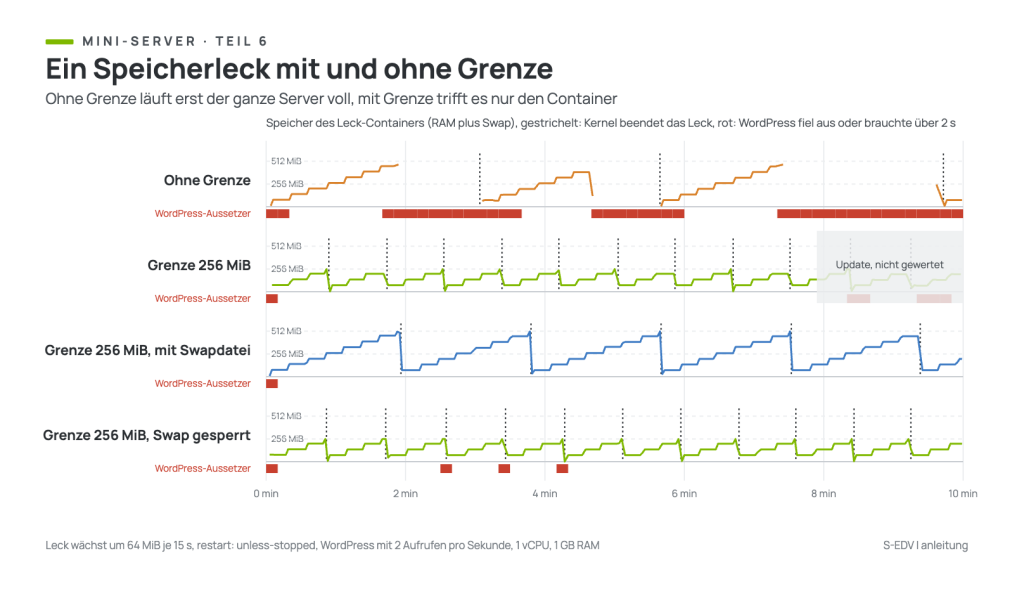
Ohne Grenze wuchs der Leck-Container auf rund 470 MiB. Dann war der Speicher des ganzen Servers voll, der Kernel beendete das Python-Programm. Schon vorher brach WordPress ein, beim dritten Mal über zwei Minuten lang, und nach dem Kill dauerte es noch bis zu einer halben Minute, bis es wieder normal antwortete. Docker startete den Container sofort neu, und nach 2,5 bis 4 Minuten wiederholte sich alles. In den 10 Minuten des Lecks beendete der Kernel es dreimal, WordPress war zusammen gut 6 Minuten weg oder brauchte über 2 Sekunden, 605 von 1.190 Aufrufen scheiterten. Getroffen hat es immer das Leck, weil es der größte Prozess war. Die Datenbank blieb verschont.
Mit Grenze beendete der Kernel das Leck jedes Mal bei 256 MiB, ohne den Rest des Servers anzufassen. Das geschah alle 50 Sekunden, in den 10 Minuten insgesamt 12-mal. WordPress bekam davon kaum etwas mit:
| Variante | Leck beendet | Fehler bei WordPress | Antwortzeit p95 |
|---|---|---|---|
| Ohne Grenze, ohne Swap | 3-mal bei rund 470 MiB | 605 von 1.190 | 10 s (Zeitlimit) |
| Grenze 256 MiB, ohne Swap | 9-mal in 7,9 min bei 256 MiB | 0 von 948 | 434 ms |
| Grenze 256 MiB, Swapdatei | 5-mal bei 256 MiB plus 256 MiB Swap | 0 von 1.200 | 361 ms |
| Grenze 256 MiB, Swap gesperrt | 12-mal bei 256 MiB | 0 von 1.200 | 834 ms |
Im Lauf mit Grenze ohne Swap startete nach knapp 8 Minuten das automatische Update von Ubuntu und belegte selbst Speicher. Die Zeile wertet deshalb nur die Zeit davor aus. Mit Swapdatei und ohne memswap_limit lagerte der Container wie in Schritt 2 beschrieben noch einmal 256 MiB aus, bevor der Kernel eingriff. Das Leck lebte dadurch rund doppelt so lange. Bei einem echten Leck verschiebt das den Absturz nur, bei einem Dienst mit kurzen Spitzen kann der Puffer helfen.
Ergebnis 2: WordPress unter Überlast
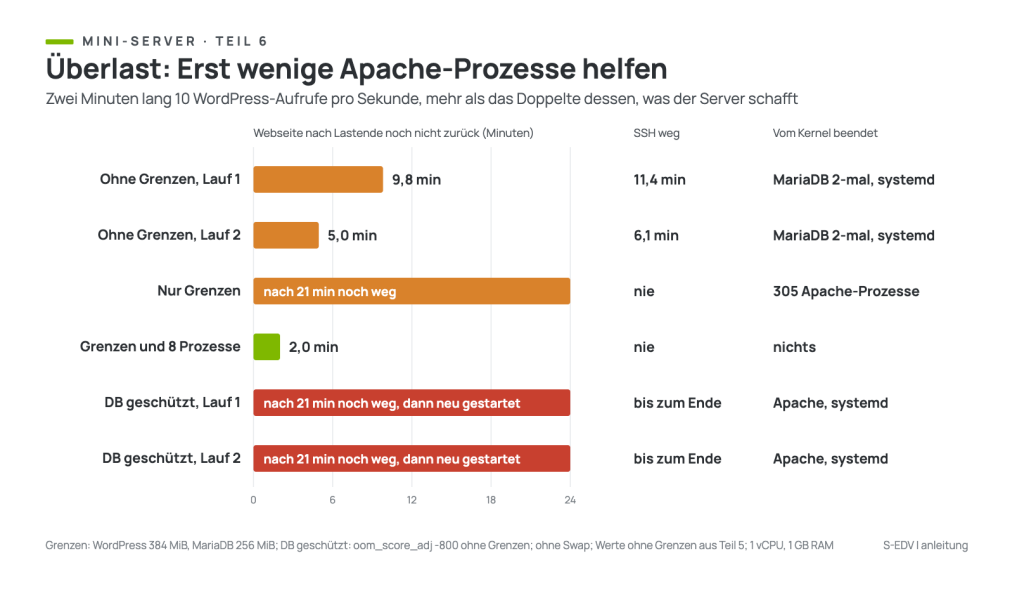
Bei 10 Aufrufen pro Sekunde scheiterten ohne Begrenzung der Apache-Prozesse über 95 % der Aufrufe in den zwei Minuten Last, mit 8 Prozessen rund 55 %. Entscheidend ist, wie der Server danach zurückkommt.
| Variante | Webseite zurück nach Lastende | SSH | Was der Kernel beendet hat |
|---|---|---|---|
| Ohne Grenzen (Teil 5, zwei Läufe) | nach 5 und 10 min | 6 und 11 min weg | MariaDB je zweimal, dazu systemd-Benutzerprozesse |
| Nur Grenzen, 150 Apache-Prozesse | nach 21 min noch nicht | immer erreichbar | 305 Apache-Prozesse |
| Grenzen und 8 Apache-Prozesse | nach 2 min | immer erreichbar | nichts |
Ohne Grenzen, MariaDB mit oom_score_adj: -800, zwei Läufe | nach 21 min noch nicht, dann hart neu gestartet | kurz nach Lastbeginn weg | Apache- und systemd-Prozesse |
Nur Grenzen hielten den Server zwar bedienbar: SSH antwortete die ganze Zeit, MariaDB blieb unberührt. Aber Apache startete im Container bis zu 150 Prozesse, die zusammen an die 384 MiB stießen. Der Kernel beendete immer wieder einzelne Apache-Prozesse, Apache startete neue, und der Container kam aus dieser Schleife nicht heraus. Die Last pendelte sich bei rund 120 bis 130 ein, 21 Minuten nach Lastende war die Seite immer noch nicht erreichbar.
Mit Grenzen und 8 Apache-Prozessen war es der einzige Lauf ohne einen einzigen Kill. Apache blieb bei 9 Prozessen, 8 Arbeiter und der Hauptprozess. WordPress brauchte höchstens 158 MiB und blieb damit weit unter seiner Grenze, verfügbar blieben immer mindestens 410 MiB, und SSH antwortete die ganze Zeit normal. Während der Last scheiterten rund 55 % der Aufrufe statt fast aller, die übrigen kamen durch. 2 Minuten nach Lastende antwortete die Seite wieder normal.
Mit geschützter Datenbank gab es den schlechtesten Verlauf. Ohne Grenzen beendet der Kernel bei vollem Speicher den größten Prozess, das war in Teil 5 MariaDB, und danach fing sich der Server. Mit oom_score_adj: -800 fiel MariaDB bei der Auswahl praktisch heraus. Der Kernel beendete stattdessen in rund 20 Minuten nur 8 und 10 kleine Prozesse, meist Apache-Prozesse und wie schon in Teil 5 die systemd-Benutzerinstanz der root-Anmeldung. Das gab kaum Speicher frei, der Speicher blieb voll, SSH fiel kurz nach Beginn der Last aus und kam nicht zurück. In beiden Läufen besserte sich in 21 Minuten nichts, der Server wurde dann hart über die Server-Verwaltung neu gestartet. MariaDB hat überlebt, nur nützte das niemandem.
Was das für Ihren Server heißt
Geben Sie jedem Container, der wachsen kann, eine Grenze. Dann trifft ein Leck nur den Verursacher, und die übrigen Dienste laufen weiter. Die Grenze ersetzt aber keine vernünftige Einstellung des Dienstes selbst: Ein Webserver, der mehr Prozesse startet, als in seine Grenze passen, fährt sich darin fest. Die Grenze schützt den Rest des Servers, die Zahl der Apache-Prozesse muss so klein sein, dass sie hineinpasst.
Die Summe der Grenzen sollte zum verfügbaren Speicher passen. Im Test lagen 640 MiB Grenzen über den rund 540 MiB, die nach dem Start verfügbar waren. Das ging gut, weil beide Container mit 8 Apache-Prozessen weit darunter blieben, WordPress bei höchstens 158 MiB, MariaDB bei rund 130 MiB. Für einen weiteren Dienst bleibt bei 1 GB RAM wenig Platz.
Schützen Sie die Datenbank nicht per oom_score_adj. Im Test nahm das dem Kernel die einfachste Möglichkeit, Speicher freizumachen.
Typische Fehler
docker statszeigt bei allen Containern den gesamten RAM als GrenzeDie Grenze fehlt oder der Container wurde nach der Änderung nicht neu angelegt.
docker compose up -dlegt geänderte Container neu an, eindocker compose restartreicht nicht.- Im Kernel-Protokoll steht
Memory cgroup out of memory: Killed process … (apache2), immer wieder Apache stößt an die Grenze seines Containers. Begrenzen Sie die Prozesse wie in Schritt 3 oder heben Sie die Grenze an. Im Test kam der Container ohne diese Änderung auch 21 Minuten nach der Last nicht aus der Schleife heraus.
- Ein Container startet ständig neu,
RestartCountsteigt Der Kernel beendet ihn an seiner Grenze, die Restart-Policy startet ihn neu. Im Test geschah das beim Leck alle 50 Sekunden. Das schützt die übrigen Dienste, löst aber das Leck nicht. Sehen Sie in
docker logsund im Kernel-Protokoll nach, was den Speicher braucht.- Nach Überlast kommt der Server nicht zurück, MariaDB hat
oom_score_adj Der Kernel beendet dann nur kleine Apache-Prozesse, die kaum Speicher freigeben. Nehmen Sie die Einstellung heraus und begrenzen Sie Speicher und Apache-Prozesse wie in Schritt 2 und 3.
Häufige Fragen
Wie groß sollte die Grenze sein?
Etwas über dem Wert, den der Container unter normaler Last braucht, siehe Schritt 1. WordPress lag im Test bei zwei Aufrufen pro Sekunde bei rund 150 bis 170 MiB, die Grenze von 384 MiB ließ Luft. Die Summe aller Grenzen sollte zum freien Speicher passen.
Was passiert ohne Swap bei memswap_limit?
Nichts. Ohne Swap auf dem Server kann ein Container nichts auslagern, egal was eingestellt ist. Die Einstellung zählt erst, wenn Swap läuft.
Gilt das auch für andere Webserver?
Gemessen wurde nur Apache im WordPress-Image. Jeder Dienst, der unter Last mehr Prozesse oder Threads startet, kann sich an einer zu engen Grenze ähnlich festfahren. Begrenzen Sie dort ebenfalls die Zahl der Prozesse.
Fazit
Speichergrenzen pro Container sind auf einem Mini-Server mit 1 GB RAM Pflicht. Ohne Grenze riss ein einziger undichter Container WordPress immer wieder mit, mit Grenze lief WordPress ohne einen Fehler weiter. Bei Überlast half die Grenze allein aber nicht, erst die Begrenzung auf 8 Apache-Prozesse brachte den Server gut durch. Mit 384 MiB für WordPress, 256 MiB für MariaDB und 8 Apache-Prozessen überstand der Mini-Server die Überlast ohne einen einzigen Kill und war 2 Minuten danach wieder normal erreichbar. Den Kernel daran zu hindern, die Datenbank zu beenden, ist dagegen eine schlechte Idee: Der Server kam in beiden Läufen nach der Überlast nicht mehr zurück. Im nächsten Teil der Reihe kommen Dienste nacheinander dazu, bis der Mini-Server bricht.
Weiterführende Anleitungen und Quellen
- Mini-Server Teil 1: Was bleibt von 1 GB RAM übrig?
- Mini-Server Teil 2: Wie viele Aufrufe schafft ein Kern?
- Mini-Server Teil 3: WordPress auf 1 GB RAM
- Mini-Server Teil 4: Vier kleine Dienste auf 1 GB RAM
- Mini-Server Teil 5: Swap, zram oder nichts?
- Docker Compose unter Linux
- Docker: Resource constraints
- Compose: Services (mem_limit, memswap_limit, oom_score_adj)
- Linux-Kernel: Control Group v2