Anubis vor der Website: KI-Crawler aussperren, Besucher durchlassen
Teil 6 der Reihe Server im Netz: Anubis als Schutz vor KI-Crawlern zwischen Caddy und eine Hugo-Website stellen. Mit den Fallen aus dem Test, darunter ein Doku-Beispiel, das alle Besucher sperrt, und eine Option, die auch Google aussperrt.
Geprüft am 04.11.2026 · für Anubis 1.28.2, Caddy 2.11.7, Lighthouse 13.6.0
Mit KI erstellt – redaktionelle Prüfung ausstehend
WerbelinksMit * markierte Links sind Werbelinks: Bei einem Kauf erhalten wir eine Provision, der Preis bleibt gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Mehr dazu
KI-Firmen lassen Crawler durchs Netz laufen, die Inhalte für das Training ihrer Modelle einsammeln. Kleine Websites merken das an Last, an Logs voller unbekannter Bots und an Texten, die anderswo zusammengefasst wieder auftauchen. Eine robots.txt ist nur eine Bitte, an die sich nicht jeder hält. Anubis geht weiter: Es steht vor der Website, sperrt bekannte KI-Crawler anhand ihrer Kennung und lässt alles, was sich als Browser ausgibt, eine kleine Rechenaufgabe lösen. Auf dem Desktop dauerte das im Test eine Viertelsekunde, für Massen-Crawler wird es teuer. Diese Anleitung stellt Anubis zwischen Caddy und die Hugo-Seite aus Teil 5 und zeigt die Stolpersteine aus dem Test, darunter eine Option, die ohne Fehlermeldung auch Google das Crawlen verbietet.
Dies ist Teil 6 der Reihe „Server im Netz“. Auf dem VPS mit der Domain sedv-lab.de liefert Caddy eine Hugo-Website mit strenger Content-Security-Policy aus. Als Beispiel dient ein netcup-VPS mit Ubuntu und Docker.
Voraussetzungen
- Der Server aus Teil 4 mit Caddy im Host-Netz und eine Website, im Beispiel die Hugo-Seite aus Teil 5
- Docker und Docker Compose
- Zugriff auf den Caddyfile
So arbeitet Anubis
Anubis ist ein kleiner Reverse Proxy. Caddy reicht jede Anfrage an Anubis weiter, Anubis entscheidet nach seinen Regeln und gibt erlaubte Anfragen an die eigentliche Website weiter. Die Standardregeln von v1.28.2 kennen drei Ausgänge: erlauben etwa für robots.txt, /.well-known/ und Favicons, sperren für bekannte KI-Crawler, Headless-Browser und verdächtige Muster, und prüfen für alles, was sich mit „Mozilla“ als Browser ausgibt. Bei der Prüfung rechnet der Browser per JavaScript eine kleine Proof-of-Work-Aufgabe und bekommt danach ein signiertes Cookie, laut Doku und im Test 168 Stunden, also sieben Tage lang. Kennungen ohne „Mozilla“ oder „Opera“, etwa von curl, bekommen kein Gewicht und kommen über die Schwelle minimal-suspicion durch, sofern sie nicht auf einer Sperrliste stehen. Anfragen ganz ohne Kennung sperrt Anubis.
Schritt 1: Anubis starten
Anubis braucht einen festen Schlüssel, damit die Cookies einen Neustart überleben. Der Container läuft als Benutzer 1000, deshalb gehört ihm die Datei:
mkdir -p /opt/anubis && cd /opt/anubis
(umask 077; openssl rand -hex 32 > anubis-key)
chown 1000:1000 anubis-key
Die compose.yaml:
services:
  anubis:
    image: ghcr.io/techarohq/anubis:v1.28.2
    container_name: anubis
    restart: unless-stopped
    network_mode: host
    environment:
      BIND: "127.0.0.1:8923"
      TARGET: "http://127.0.0.1:8080"
      METRICS_BIND: "127.0.0.1:9090"
      COOKIE_DOMAIN: "sedv-lab.de"
      REDIRECT_DOMAINS: "sedv-lab.de"
      SERVE_ROBOTS_TXT: "false"
      ED25519_PRIVATE_KEY_HEX_FILE: "/run/secrets/anubis-key"
    volumes:
      - ./anubis-key:/run/secrets/anubis-key:ro
Anubis läuft wie Caddy im Host-Netz und lauscht nur auf 127.0.0.1, von außen ist es nicht erreichbar. REDIRECT_DOMAINS ist wichtig: Ohne diese Angabe warnte Anubis beim Start REDIRECT_DOMAINS is not set, Anubis will redirect to any domain. Nach der Prüfung würde es also auf jede beliebige Adresse weiterleiten, eine offene Weiterleitung, die sich für Phishing-Links missbrauchen lässt. Zu SERVE_ROBOTS_TXT kommen wir in Schritt 5.
docker compose up -d
docker logs anubis 2>&1 | grep listening
Zwei Warnungen zu GeoIP und eine zu USE_SIMPLIFIED_EXPLANATION beim Start sind harmlos: Die Standardregeln enthalten Länder- und Netzprüfungen, für die Anubis eine eigene Datenbank bräuchte. Ohne sie bleiben diese Regeln einfach wirkungslos.
Verifizieren: Das Log zeigt listening mit http://127.0.0.1:8923 und version v1.28.2, ss -tlnp | grep 8923 zeigt den Port nur auf 127.0.0.1.
Schritt 2: Caddy umbauen
Bisher lieferte Caddy die Dateien im Block sedv-lab.de direkt aus. Jetzt teilt sich das auf zwei Blöcke: Der öffentliche Block reicht an Anubis weiter, ein interner Block auf 127.0.0.1:8080 liefert die Dateien aus. Die strenge CSP aus Teil 5 wandert dabei in den internen Block, warum, zeigt Schritt 4:
(csp) {
	header {
		Content-Security-Policy "default-src 'self'; script-src 'self' 'sha256-...'; img-src 'self' data:; object-src 'none'; base-uri 'self'; form-action 'self'; frame-ancestors 'none'"
	}
}

sedv-lab.de {
	import sicher
	header ?Content-Security-Policy "default-src 'self'; script-src 'self' 'unsafe-inline'; style-src 'self' 'unsafe-inline'; font-src 'self' data:; img-src 'self' data:; worker-src 'self' blob:; object-src 'none'; base-uri 'self'; form-action 'self'; frame-ancestors 'none'"
	@assets path /assets/*
	header @assets Cache-Control "public, max-age=31536000, immutable"
	reverse_proxy 127.0.0.1:8923 {
		header_up X-Real-Ip {remote_host}
		header_up X-Http-Version {http.request.proto}
		header_up X-Tls-Sni-Name {http.request.tls.server_name}
	}
}

http://:8080 {
	bind 127.0.0.1
	import csp
	root * /srv/site
	file_server
	encode zstd gzip
}
Der Ausschnitt ist gekürzt: Der Block (sicher) aus Teil 4 bleibt, nur ohne die Zeile mit der CSP, ebenso das Logging und die Blöcke für www und Port 80. Der interne Block heißt bewusst http://:8080 und nicht http://127.0.0.1:8080: Anubis reicht den Host sedv-lab.de weiter, und ein Block mit Namen 127.0.0.1 hätte darauf nicht reagiert. Im Test bekamen curl und Skripte genau deshalb zunächst eine leere Seite mit Status 200.
Weil das Caddyfile einzeln in den Container eingebunden ist, laden Sie nach jeder Änderung neu und prüfen, ob der Container die neue Fassung sieht:
docker exec caddy caddy reload --config /etc/caddy/Caddyfile
docker exec caddy grep -c "8923" /etc/caddy/Caddyfile
Im Test hatten wir eine Zeile mit sed -i geändert. Das legt eine neue Datei an, und der Container sah weiter die alte, bis wir ihn mit docker restart caddy neu starteten.
Verifizieren: curl -s https://sedv-lab.de/ | grep -o "<title>[^<]*" zeigt den Titel der Website.
Schritt 3: Die Falle im Caddy-Beispiel der Doku
Die Anubis-Doku schlägt für Caddy die Zeile header_up X-TLS-SNI-Name {tls_server_name} vor. Damit sperrte Anubis im Test jeden Besucher, Browser wie curl, mit der Seite „Oh noes!“. Im Log stand bei jeder Anfrage:
"msg":"explicit deny", ... "check_result":{"name":"bot/domain-fronting","rule":"DENY","weight":0}Die Regel domain-fronting sperrt, wenn der Header X-Tls-Sni-Name nicht zum angefragten Host passt. Ein Mitschnitt auf der Loopback-Schnittstelle zeigte, was Caddy tatsächlich schickte: X-Tls-Sni-Name: {tls_server_name}, den Platzhalter also wörtlich. Eine Kurzform {tls_server_name} kennt Caddy nicht, und unbekannte Platzhalter lässt es in Header-Werten einfach stehen. Richtig ist {http.request.tls.server_name} wie im Caddyfile oben. Die Zeile ganz wegzulassen hätte die Sperre ebenfalls beendet, mit dem richtigen Platzhalter bleibt der Schutz gegen Domain Fronting aber erhalten.
Verifizieren: docker logs anubis 2>&1 | grep -c domain-fronting zählt nach dem Neuladen nicht mehr weiter, wenn Sie die Seite mit curl aufrufen.
Schritt 4: Die CSP und die Prüfseite
Die Prüfseite von Anubis kommt mit eigenen Inline-Skripten, Inline-Stilen, eingebetteten Schriften und einem Web-Worker für die Rechenaufgabe. Unter der strengen CSP aus Teil 5 meldete Chrome auf der Prüfseite unter anderem Creating a worker from 'blob:https://sedv-lab.de/...' violates the following Content Security Policy directive und blockierte Schriften und Skripte. Anubis selbst setzt keine CSP. Hashes für die Prüfseite haben wir nicht verwendet, sie müssten bei jedem Anubis-Update neu berechnet werden.
Die Lösung im Caddyfile oben: Die strenge CSP setzt nur der interne Block, Anubis reicht sie bei normalen Seiten durch. Für alle Antworten ohne CSP, also die Seiten von Anubis, setzt der öffentliche Block mit header ?Content-Security-Policy eine lockerere Fassung. Das Fragezeichen bedeutet: nur setzen, wenn die Antwort noch keine CSP hat. Die lockere Fassung trifft damit Antworten, die Anubis selbst erzeugt, also Prüf- und Sperrseite und seine Dateien unter /.within.website/, und Fehlerseiten von Caddy, falls Anubis ausfällt. Website-Seiten einschließlich 404 kommen aus dem internen Block und tragen die strenge CSP. Wichtig: Jeder weitere Block, den Sie später hinter Anubis hängen, braucht ebenfalls import csp, sonst bekommt er stillschweigend die lockere Fassung. Für eine statische Seite ohne Anmeldung ist das Restrisiko gering, denn auf den Seiten von Anubis läuft nur dessen eigener Code.
Verifizieren: curl -sI https://sedv-lab.de/ zeigt die CSP mit den Skript-Hashes, curl -sI -A "Mozilla/5.0 Firefox/144.0" https://sedv-lab.de/ die lockerere mit unsafe-inline.
Schritt 5: Bloß nicht SERVE_ROBOTS_TXT
Anubis kann eine eigene robots.txt ausliefern, die KI-Crawler ausschließt. Im Test liefen wir zuerst mit SERVE_ROBOTS_TXT: "true". Die Datei hatte 164 Zeilen mit User-agent, und am Ende stand:
User-agent: *
Disallow: /
Damit verbietet die Seite jedem Crawler das Crawlen, auch Google und Bing. Die Seite wird nicht mehr aktualisiert und fällt mit der Zeit aus den Ergebnissen oder erscheint nur noch ohne Beschreibung, ohne dass irgendwo ein Fehler erscheint. Die Doku beschreibt das Verhalten, doch der Name der Option verrät es nicht. Für eine Website, die gefunden werden soll, lassen Sie die Option auf false. Die robots.txt kommt dann wieder von Hugo, und die bekannten KI-Crawler sperrt Anubis über ihre Kennung. Eine Ausnahme nennen die Regeln von Anubis selbst: Googles KI-Training läuft über den erlaubten Googlebot. Wer das ausschließen will, trägt in die Hugo-robots.txt zusätzlich User-agent: Google-Extended mit Disallow: / ein.
Verifizieren: curl -s https://sedv-lab.de/robots.txt zeigt Disallow: ohne Schrägstrich und die Sitemap.
Schritt 6: Testen mit echten Kennungen
Mit curl und gefälschten Kennungen lässt sich schnell prüfen, wer was bekommt:
curl -s -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; GPTBot/1.3; +https://openai.com/gptbot)" https://sedv-lab.de/ | grep -o "<title>[^<]*"| Kennung | Ergebnis im Test | Regel |
|---|---|---|
| GPTBot, ClaudeBot | gesperrt, Seite „Oh noes!“ | bot/ai-crawlers-training |
| PerplexityBot, Bytespider | gesperrt | bot/ai-catchall |
| Firefox, Chrome | Prüfseite, danach die Website | Gewicht 10 für „Mozilla“, bei Chrome belegt: threshold/moderate-suspicion |
| Googlebot-Kennung von unserer Server-IP | Prüfseite | Kennung allein reicht nicht |
| curl, python-requests | direkt die Website | Gewicht 0, minimal-suspicion |
| Chrome mit Kennung „HeadlessChrome“ | gesperrt | bot/headless-chrome |
Die gefälschte Googlebot-Kennung kam nicht durch, weil die Standardregeln gute Crawler zusätzlich an ihren IP-Bereichen oder per Reverse-DNS erkennen. Den echten Googlebot konnten wir naturgemäß nicht testen. Beachten Sie die letzte Zeile: Auch eigene Werkzeuge, die sich mit „HeadlessChrome“ in der Kennung melden, etwa für Bildschirmfotos, sperrt Anubis. Diese Sperre greift sogar vor der Freigabe für /robots.txt.
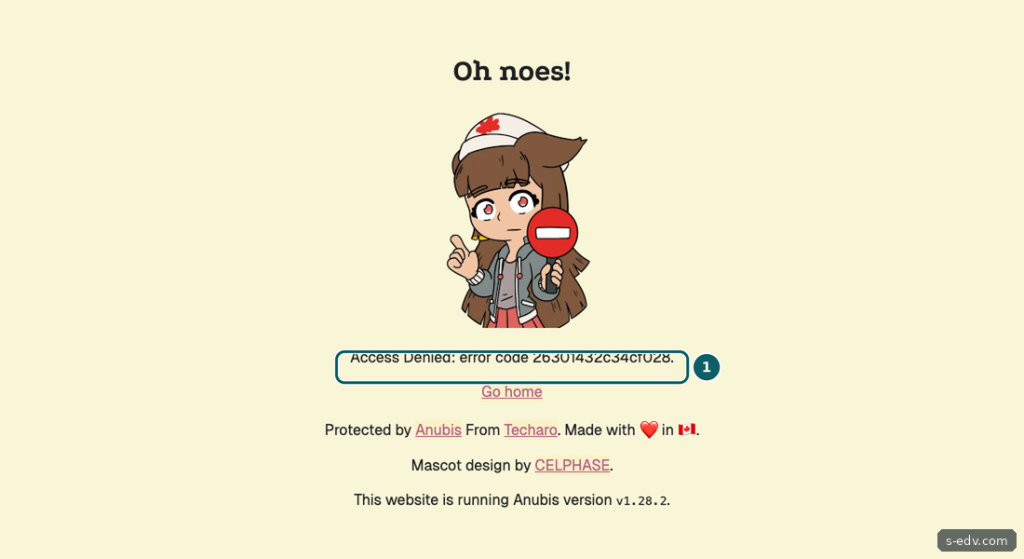
Die Sperrseite kommt mit Status 200. Das ist Absicht: Laut Doku soll der Crawler glauben, er habe Erfolg gehabt.
Ein echter Chrome am Desktop ohne Cookie bekam die Prüfung: Zwischen „new challenge issued“ und „challenge accepted“ lagen im Log 235 Millisekunden. Die Prüfseite erschien mit deutscher Überschrift, war aber so schnell wieder weg, dass sie im Bildschirmfoto gar nicht zu sehen war. Die Kennzahlen von Anubis unter http://127.0.0.1:9090/metrics zeigten für die Rechenaufgabe im Schnitt 42 Millisekunden.
Verifizieren: curl -s 127.0.0.1:9090/metrics | grep anubis_policy_results zählt die Entscheidungen je Regel.
Schritt 7: Was Anubis an den Messwerten ändert
Lighthouse meldet sich mit einer Handy-Kennung, und auch Mozilla Observatory bekam die Prüfseite. Beide Werkzeuge zeigen danach andere Werte, aus unterschiedlichen Gründen:
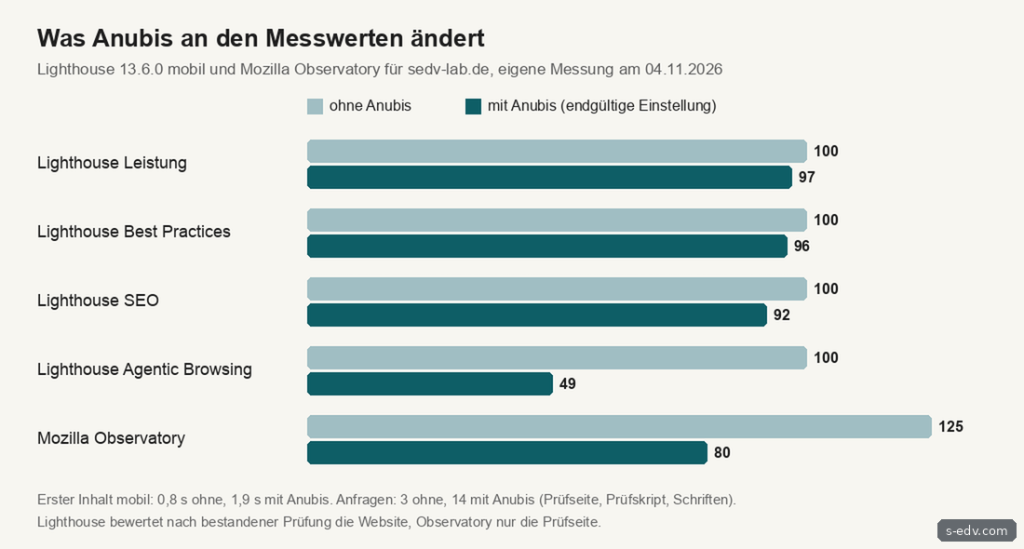
Lighthouse löste die Prüfung und bewertete am Ende die Website, zählte die Prüfung aber mit. Der erste Inhalt kam nach 1,9 statt 0,8 Sekunden, Lighthouse wies 1,8 Sekunden für die Weiterleitung aus, und die Zahl der Anfragen stieg von 3 auf 14. SEO fiel auf 92, weil Lighthouse die robots.txt mit der Kennung „HeadlessChrome“ abruft und dafür die Sperrseite bekam. Agentic Browsing fiel auf 49: Für Browser-Kennungen ohne Cookie liefert Anubis auch unter Pfaden wie /llms.txt die Prüfseite mit Status 200 statt einer 404. Bei Best Practices blieb ein CSP-Hinweis aus der Prüfung, dessen Quelle Lighthouse nicht nennt. Observatory führt kein JavaScript aus und bewertet nur die Prüfseite: ohne die zweite CSP B mit 75 Punkten, mit ihr B+ mit 80, weil sie unsafe-inline enthält. Wer Messwerte für die eigentliche Seite braucht, misst vor dem Einbau.
Für Suchmaschinen gilt dasselbe Prinzip anders herum: Echte Crawler von Google, Bing und anderen lassen die Standardregeln anhand von Kennung und IP-Bereich oder Reverse-DNS durch. Die Listen sind in die Version eingebaut und können veralten. Probieren Sie nach dem Einbau den URL-Test in der Search Console aus und behalten Sie die Abdeckung im Blick.
Verifizieren: curl -s -A "Mozilla/5.0 Firefox/144.0" https://sedv-lab.de/ | grep -o 'noindex,nofollow' zeigt, dass Browser-Kennungen ohne Cookie zuerst die Prüfseite bekommen.
Typische Fehler
| Meldung oder Beobachtung | Ursache und Lösung |
|---|---|
Jeder Besucher bekommt „Oh noes!“, im Log bot/domain-fronting | Caddy schickt den Platzhalter {tls_server_name} wörtlich. {http.request.tls.server_name} nutzen, Schritt 3. |
| curl bekommt Status 200 mit leerer Seite | Interner Block hört nur auf den Namen 127.0.0.1. Als http://:8080 mit bind 127.0.0.1 anlegen. |
Creating a worker from 'blob:...' violates the following Content Security Policy directive | Strenge CSP auf der Prüfseite. CSP in den internen Block verschieben, Schritt 4. |
REDIRECT_DOMAINS is not set, Anubis will redirect to any domain | Offene Weiterleitung. REDIRECT_DOMAINS auf die eigene Domain setzen. |
robots.txt endet mit User-agent: * und Disallow: / | SERVE_ROBOTS_TXT ist an. Auf false stellen, Schritt 5. |
| Eigenes Überwachungswerkzeug wird gesperrt | Kennung mit „HeadlessChrome“ fällt unter bot/headless-chrome. Für die Überwachung eine einfache HTTP-Prüfung ohne Browser nutzen. |
Häufige Fragen
Reicht nicht eine robots.txt gegen KI-Crawler?
Sie ist eine Bitte. Seriöse Anbieter halten sich daran, viele andere nicht. Anubis sperrt die bekannten Kennungen hart und macht das massenhafte Abrufen für alle, die sich als Browser tarnen, teurer.
Merken Besucher etwas?
Im Test dauerte die Prüfung in Chrome am Desktop 235 Millisekunden, auf schwachen Handys dauert sie länger. Danach gilt das Cookie sieben Tage, solange der Browser es behält. Ohne JavaScript kommt niemand durch, der sich als Browser ausgibt. Für Leser mit abgeschaltetem JavaScript ist Anubis also eine Hürde.
Funktionieren RSS-Feeds noch?
Im Test bekam ein Aufruf von /index.xml mit Firefox-Kennung die Prüfseite, mit curl kam der Feed durch. Viele Feed-Leser geben sich aber als „Mozilla“ aus und bekommen dann die Prüfseite, die sie nicht lösen können. Prüfen Sie Ihren Feed-Leser.
Wie viel Last spart Anubis?
Das hängt davon ab, wie viele Crawler Ihre Seite besuchen. Eine neue Testdomain wie unsere bekommt anfangs wenig Besuch. Die echten Zahlen werten wir in Teil 7 mit GoAccess aus.
Fazit
Anubis sperrte im Test die bekannten KI-Crawler zuverlässig und ließ echte Browser nach einer Viertelsekunde durch. Der Einbau hinter Caddy ist in wenigen Minuten erledigt, die Arbeit steckt in den Details. Das Caddy-Beispiel der Doku sperrte alle Besucher, eine strenge CSP gehört in den internen Block, und SERVE_ROBOTS_TXT darf auf einer Seite, die gefunden werden soll, nicht an sein. Rechnen Sie außerdem damit, dass Prüfwerkzeuge danach schlechtere Werte zeigen: Lighthouse zählt die Prüfung mit, Observatory bewertet nur die Prüfseite.
Weiterführende Anleitungen und Quellen
- Teil 5: Eigene Website mit Hugo
- Teil 4: Caddy als Eingangstür
- Docker und Docker Compose auf Linux installieren
- Docker Compose absichern
- Anubis auf GitHub
- Anubis: Standardregeln v1.28.2
- Anubis: Installation und Umgebungsvariablen
- Anubis: Beispiel für Caddy
- Caddy: Platzhalter
- Caddy: Kurzformen der Platzhalter
- Caddy: Direktive header